この記事の内容
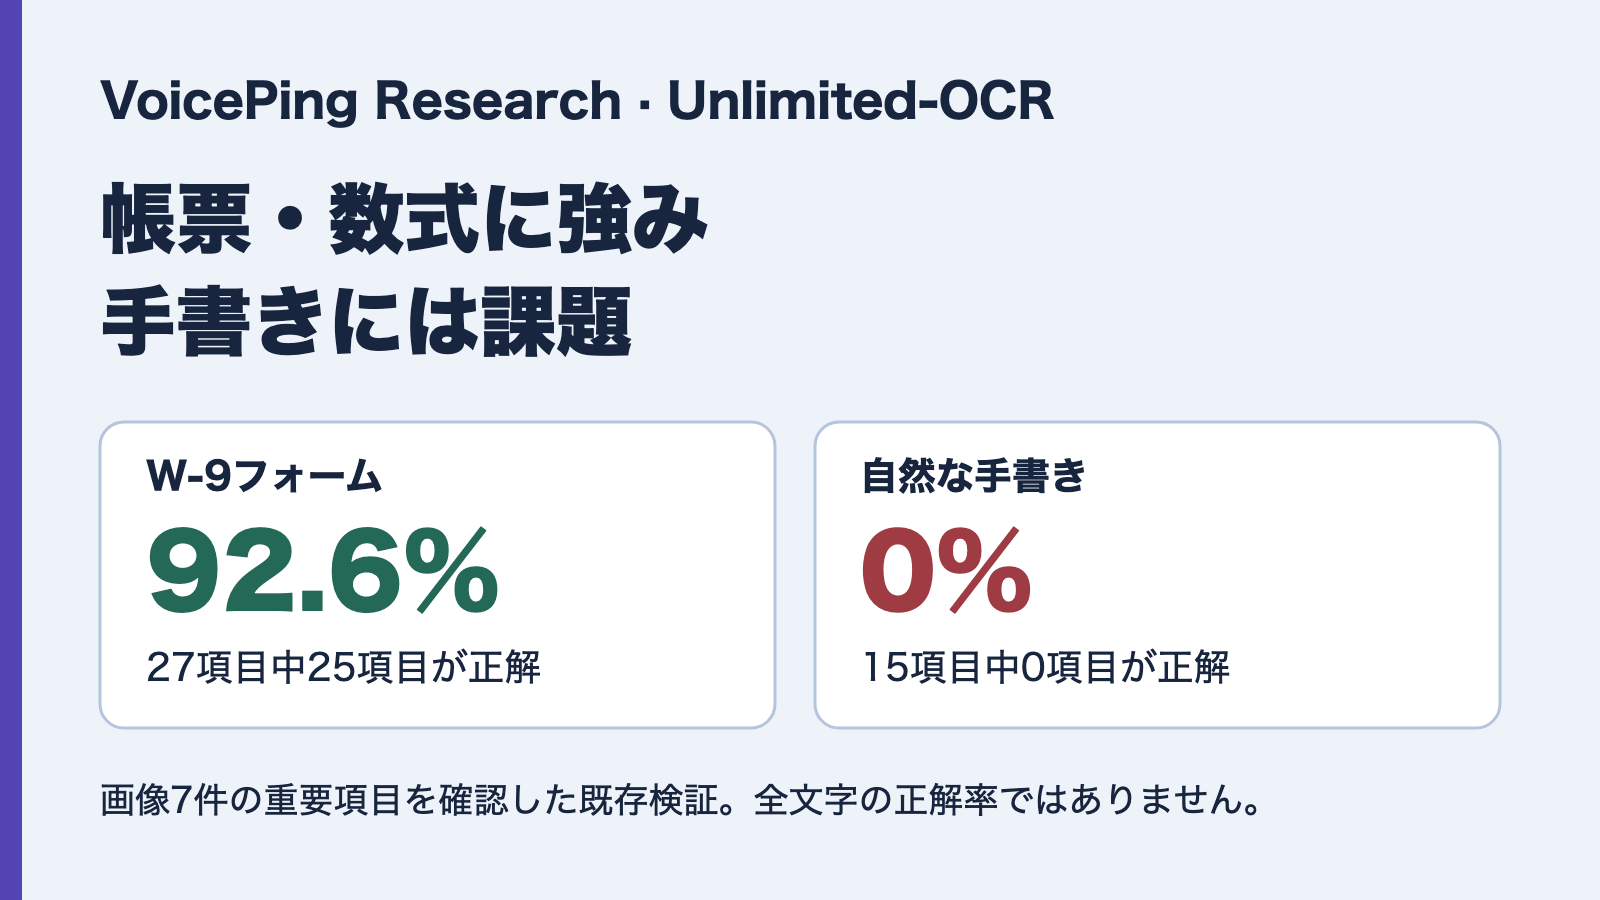
文書画像から文字を取り出すUnlimited-OCRの既存検証では、帳票の表や論文の数式を再構成できても、文字や記号が正しいとは限りませんでした。 W-9フォームは重要項目27件中25件が正解でしたが、分類を表す文字に誤りが残りました。手書きでは15件中0件となり、本文の大半が失われています。
本稿は、当社が2026年7月30日に公開した検証 を基に、画像7件と複数ページ文書3件の結果を整理したものです。公式資料は2026年9月19日に再確認しました。以下の数値は公開済みの実行記録に基づき、今回の更新でモデルを再実行した結果ではありません。
結果の要点:構造と文字を分けて評価する
見出し、表、数式、ページの境界といった文書の構造は、比較的よく残りました。一方、手書き、細かい新聞文字、撮影した文書では、読み落としや元の画像にない文章の生成が見られます。
次の表は、元の検証で確認した重要項目の正解数と実行時間です。項目とは、見出し、数値、フォームのラベル、文、数式など、画像上で確認した単位を指します。
| 入力文書 | 正解数 / 確認項目数 | 記録された実行時間 | 主な問題 |
|---|---|---|---|
| W-9フォーム | 25 / 27(92.6%) | 33.9秒 | 分類の取り違え、末尾の欠落 |
| 数式のページ | 12 / 13(92.3%) | 19.0秒 | 数式の添字が変化 |
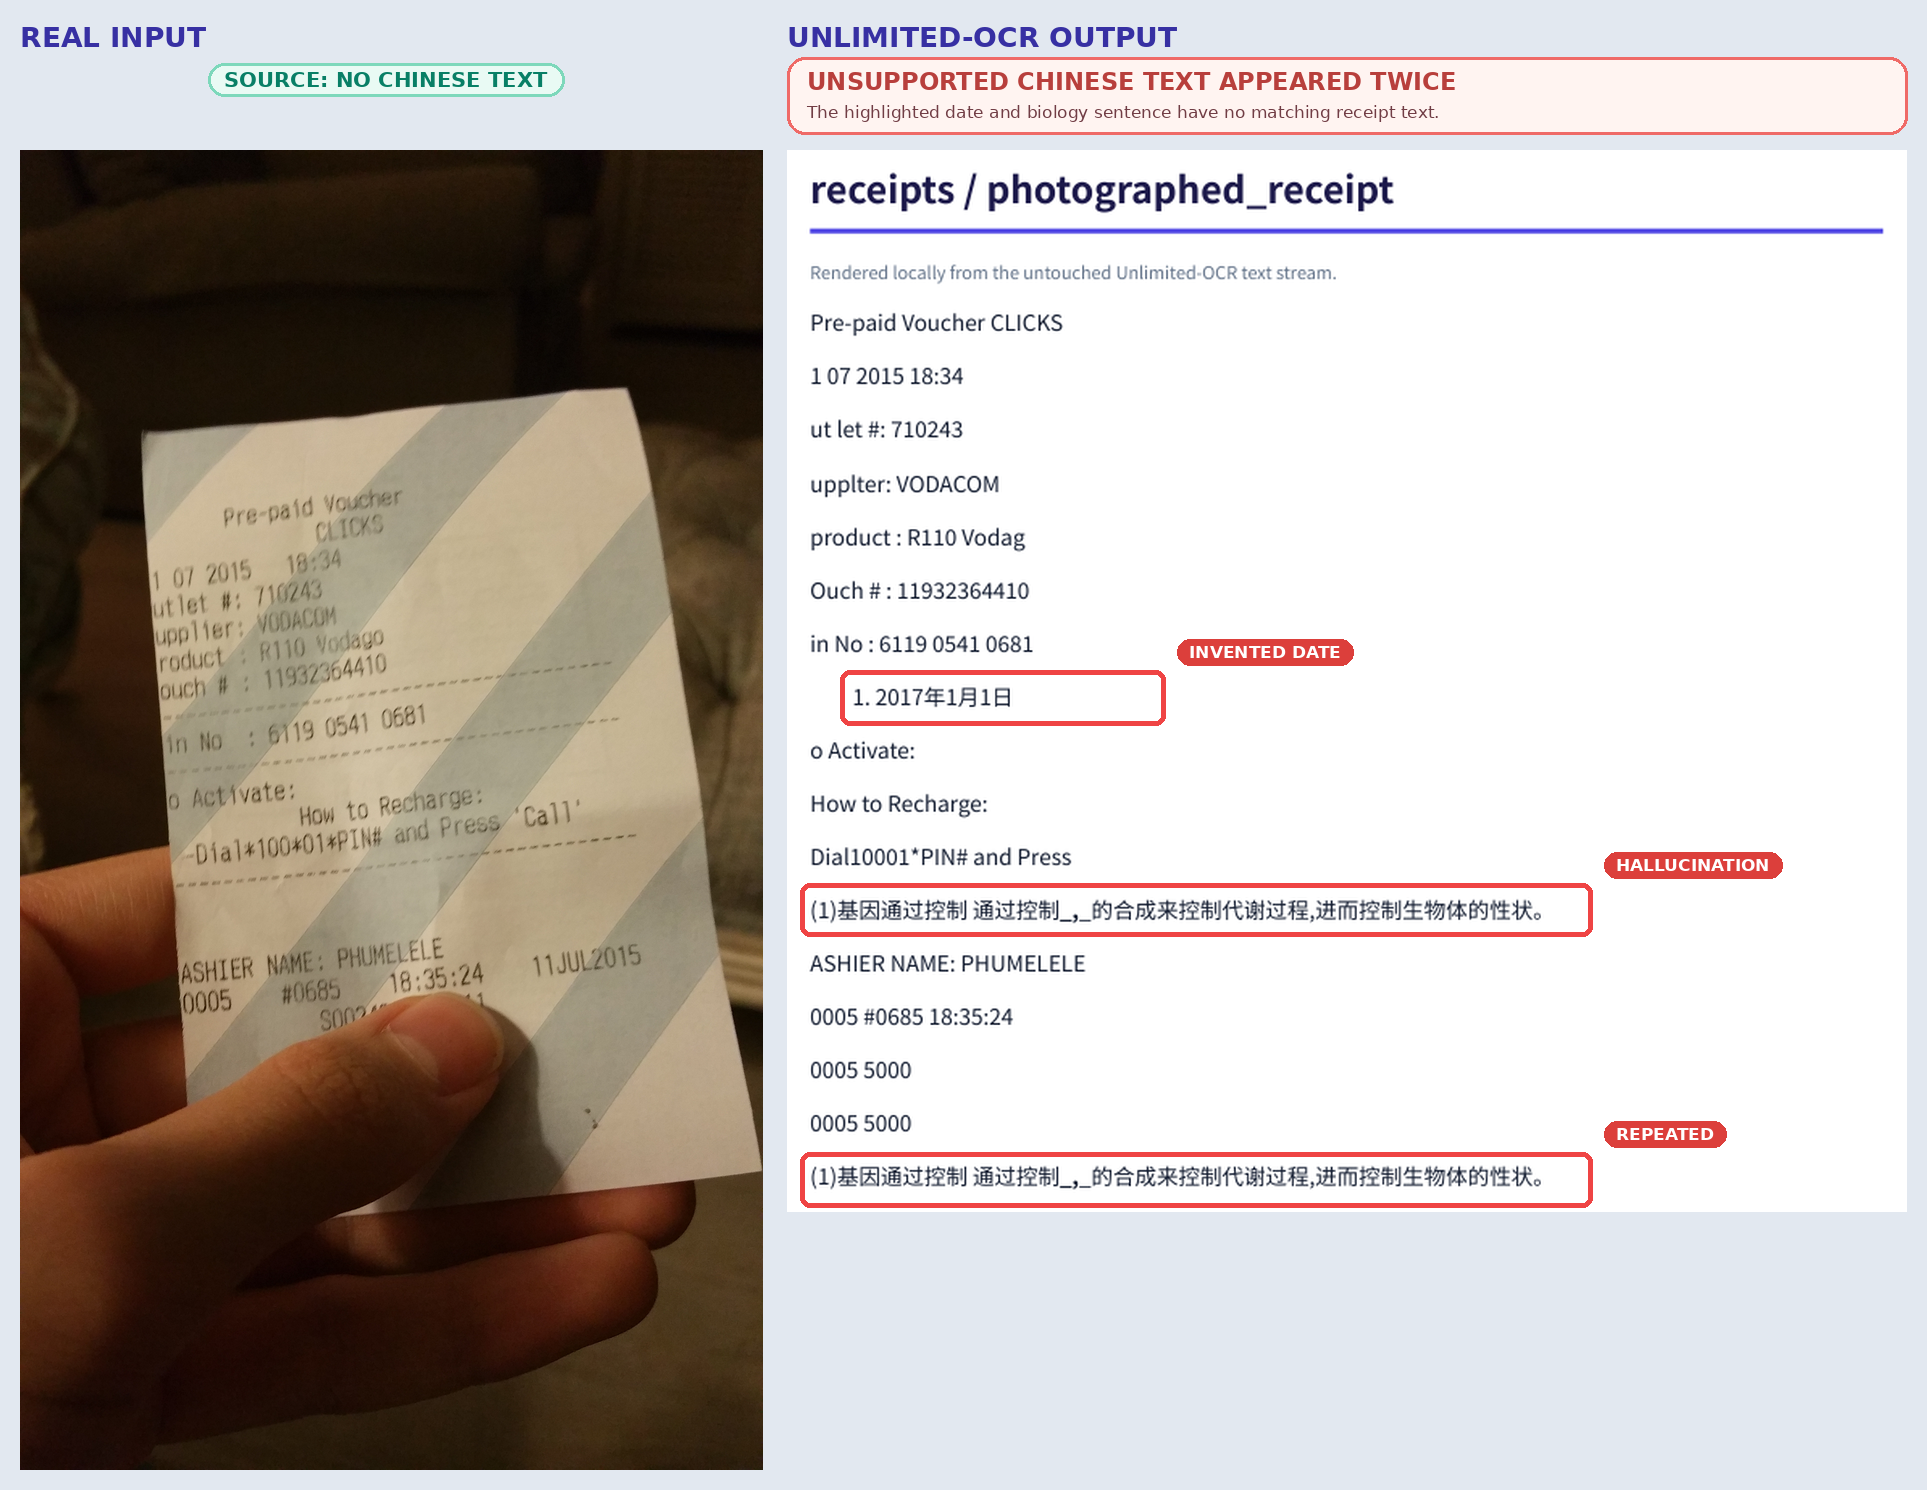
| レシート写真 | 10 / 15(66.7%) | 8.6秒 | 原文にない中国語と数字 |
| 論文の1ページ目 | 7 / 14(50.0%) | 9.5秒 | 図の内部ラベルが欠落 |
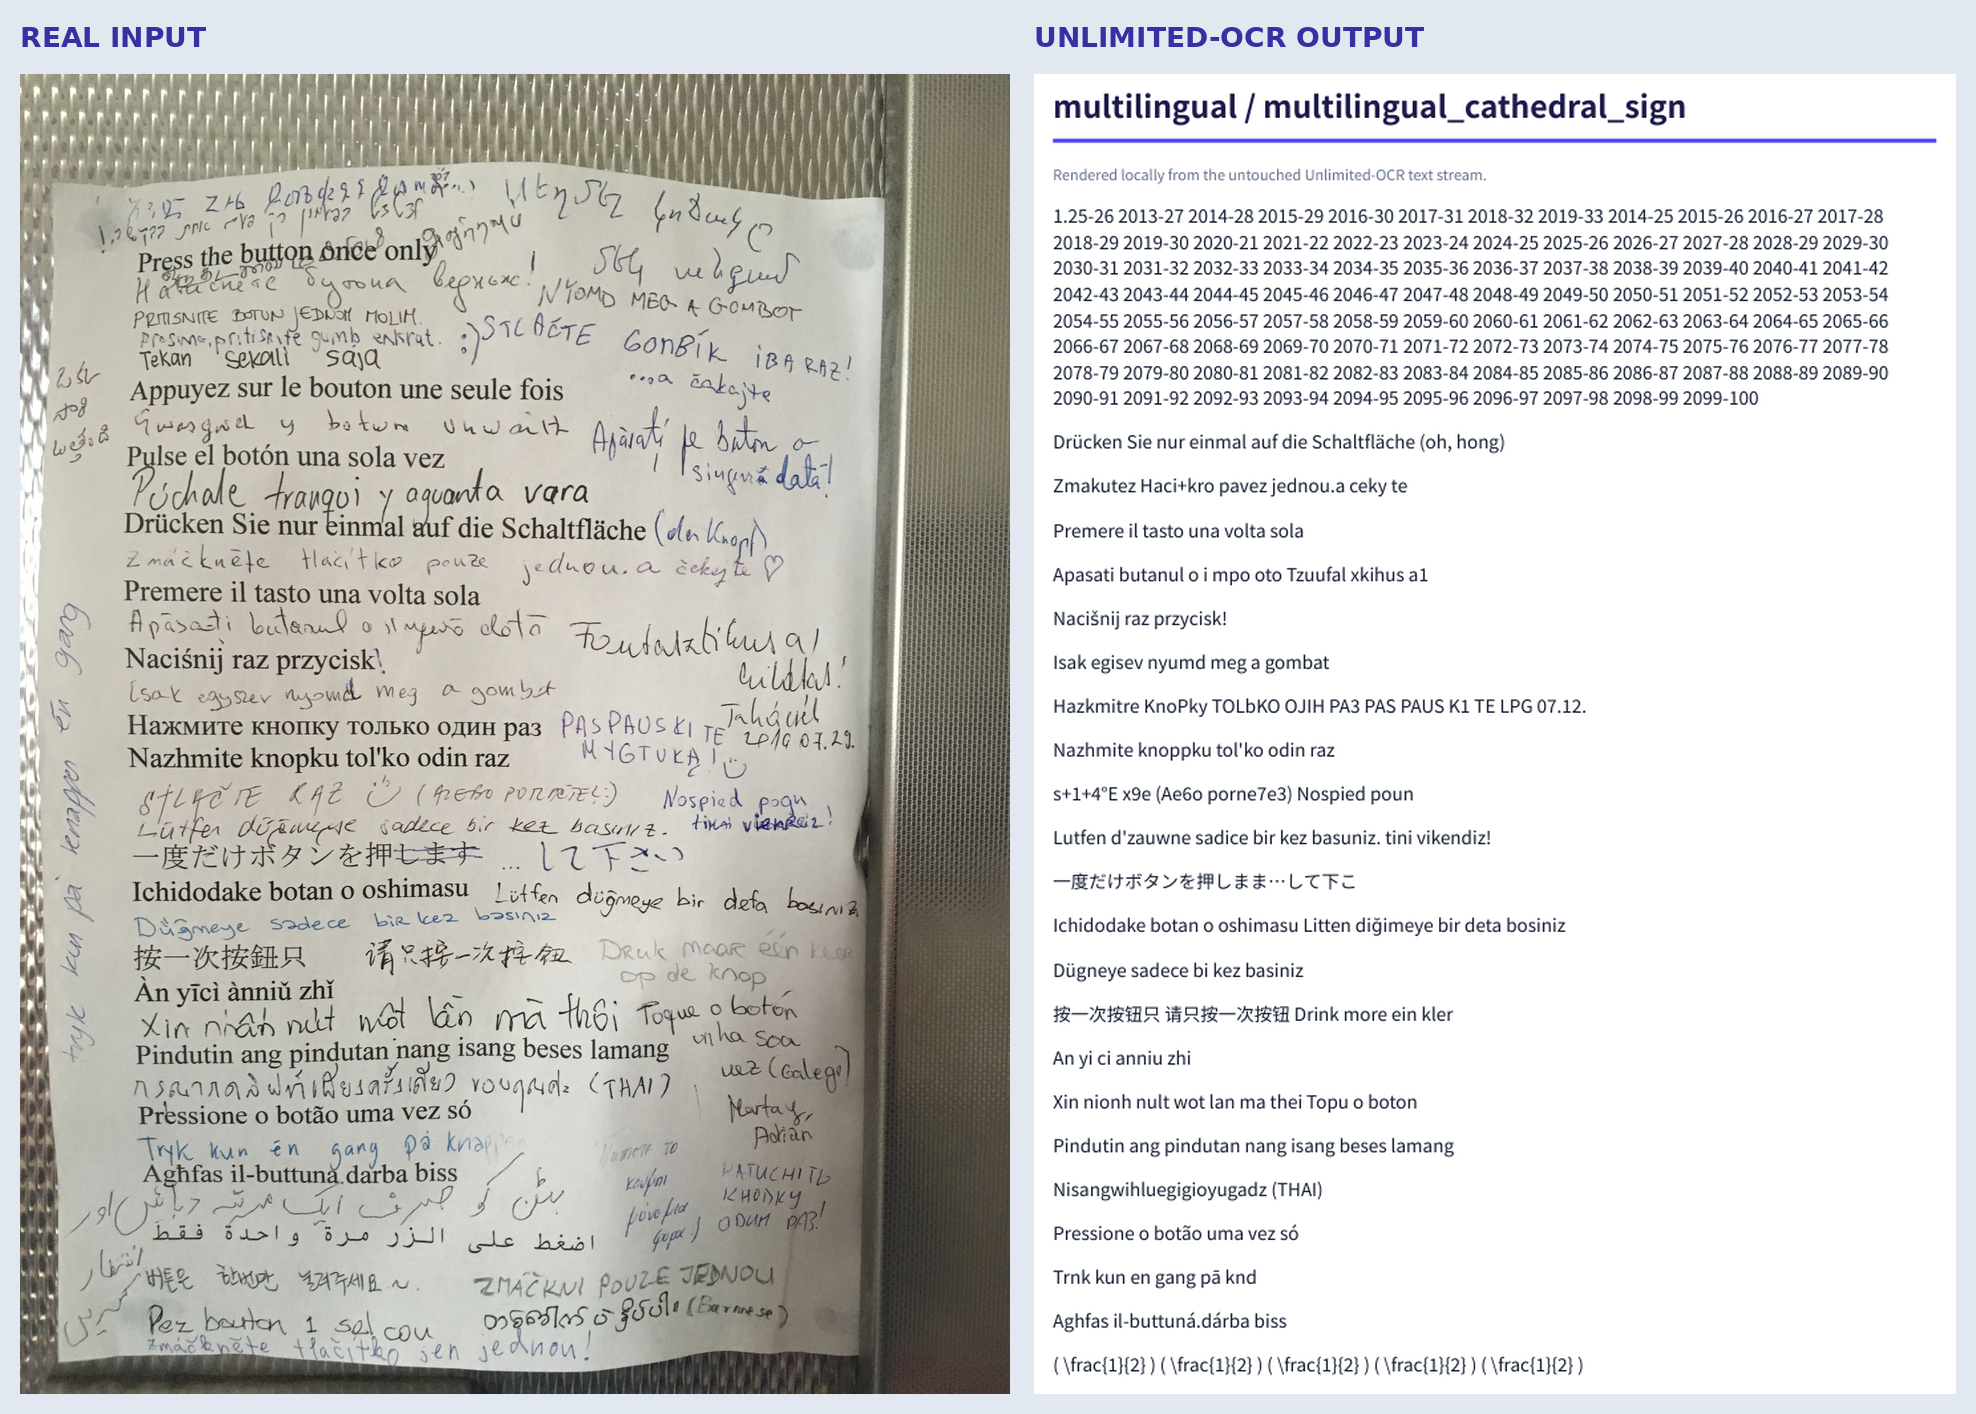
| 多言語の看板 | 6 / 15(40.0%) | 26.6秒 | 文字の崩れ、数字の追加 |
| 細かい新聞文字 | 3 / 15(20.0%) | 355.3秒 | 文章の追加、繰り返し |
| 自然な手書き | 0 / 15(0%) | 1.9秒 | 大半が欠落、短い語の反復 |
合計は114項目中63項目、55.3%です。文書ごとの百分率を単純平均せず、正解数の合計を確認項目数の合計で割っています。大文字・小文字、句読点、空白の差は許容し、主要な内容の欠落・変更・重複・追加は誤りとして数えました。
確認にはGPT-5.6 Solのxhigh設定を補助として使用したと原記事に記録されています。参照資料はPDF内のテキスト、米国の税務当局IRSのW-9、米国議会図書館の転記、画像の目視確認です。この指標は重要項目の正解率であり、全文字を対象にした文字誤り率(CER)とは異なります。各種類の画像は1件ずつなので、文書の種類全体に一般化できません。実行時間も反復測定の中央値や処理能力を示す値ではありません。
公式の設計と検証時の条件
画像を参照し続ける長文書向けの設計
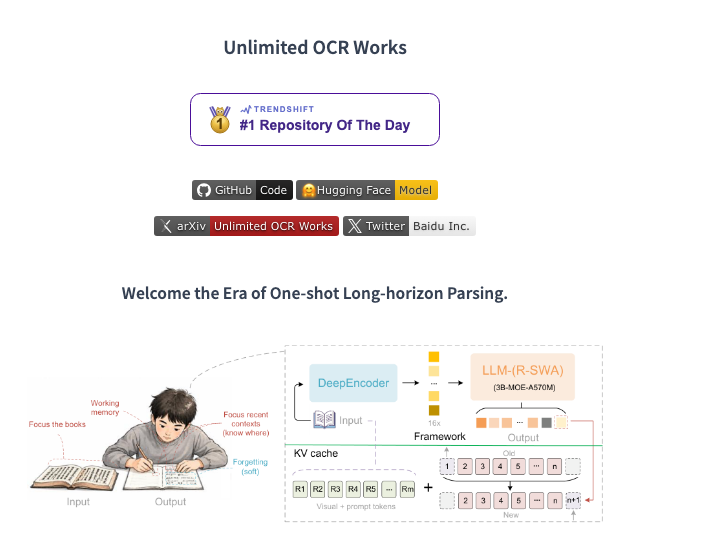
論文「Unlimited OCR Works」 は、元の画像を参照しながら、生成済みテキストの参照範囲を直近の一定区間に絞る方式を提案しています。これがR-SWA(Reference Sliding Window Attention)です。出力が長くなるほど膨らむ推論用キャッシュを抑え、長文書を処理する狙いがあります。
公式コード には単一画像と複数画像・PDFの推論経路があり、推論例の最大長は32,768トークンです。「Unlimited」という名称でも、出力長や使用メモリの制約がなくなるわけではありません。
公式の構造化出力は、今回の表・見出し・数式にも現れました。複数ページの一括処理は2ページと14ページで順序を保てた一方、6ページでは重複と欠落が発生しています。多言語の対象であることと、個々の言語・筆跡を正確に読めることも分けて判断します。
GPU・出力上限・入力文書
原記事では、NVIDIA RTX PRO 6000 Blackwell Max-Q GPUで、数値を16ビットで扱うBF16形式のモデルを実行しました。CPUへの切り替えを無効にし、出力上限を32Kに設定しています。画像7件に加え、2・6・14ページの文書を評価しました。
主要なソフトウェアはPython 3.12、PyTorch 2.10.0、TorchVision 0.25.0、Transformers 4.57.1、Hugging Face Hub 0.34.4、Pillow 12.1.1、PyMuPDF 1.27.2.2です。保存した出力の表示にはMarkdown 3.8.2とWeasyPrint 66.0を使用しています。これは当時の測定条件であり、最新の推奨構成一覧ではありません。
原記事では、入力、加工前の出力、構造化データ、設定、エラー、比較画像を保存したとしています。ただし、モデルの固定リビジョンや全114項目の採点表は本文に掲載されていません。厳密な追試にはそれらの記録も必要です。ここでは掲載済みの比較画像と集計値から読み取れる範囲を示します。
帳票・数式は形を保っても誤読が残る
以下の比較画像は、左が入力、右がUnlimited-OCRの出力です。画像を開くと、元の解像度で拡大して確認できます。
論文の1ページ目:図の内部文字が欠落
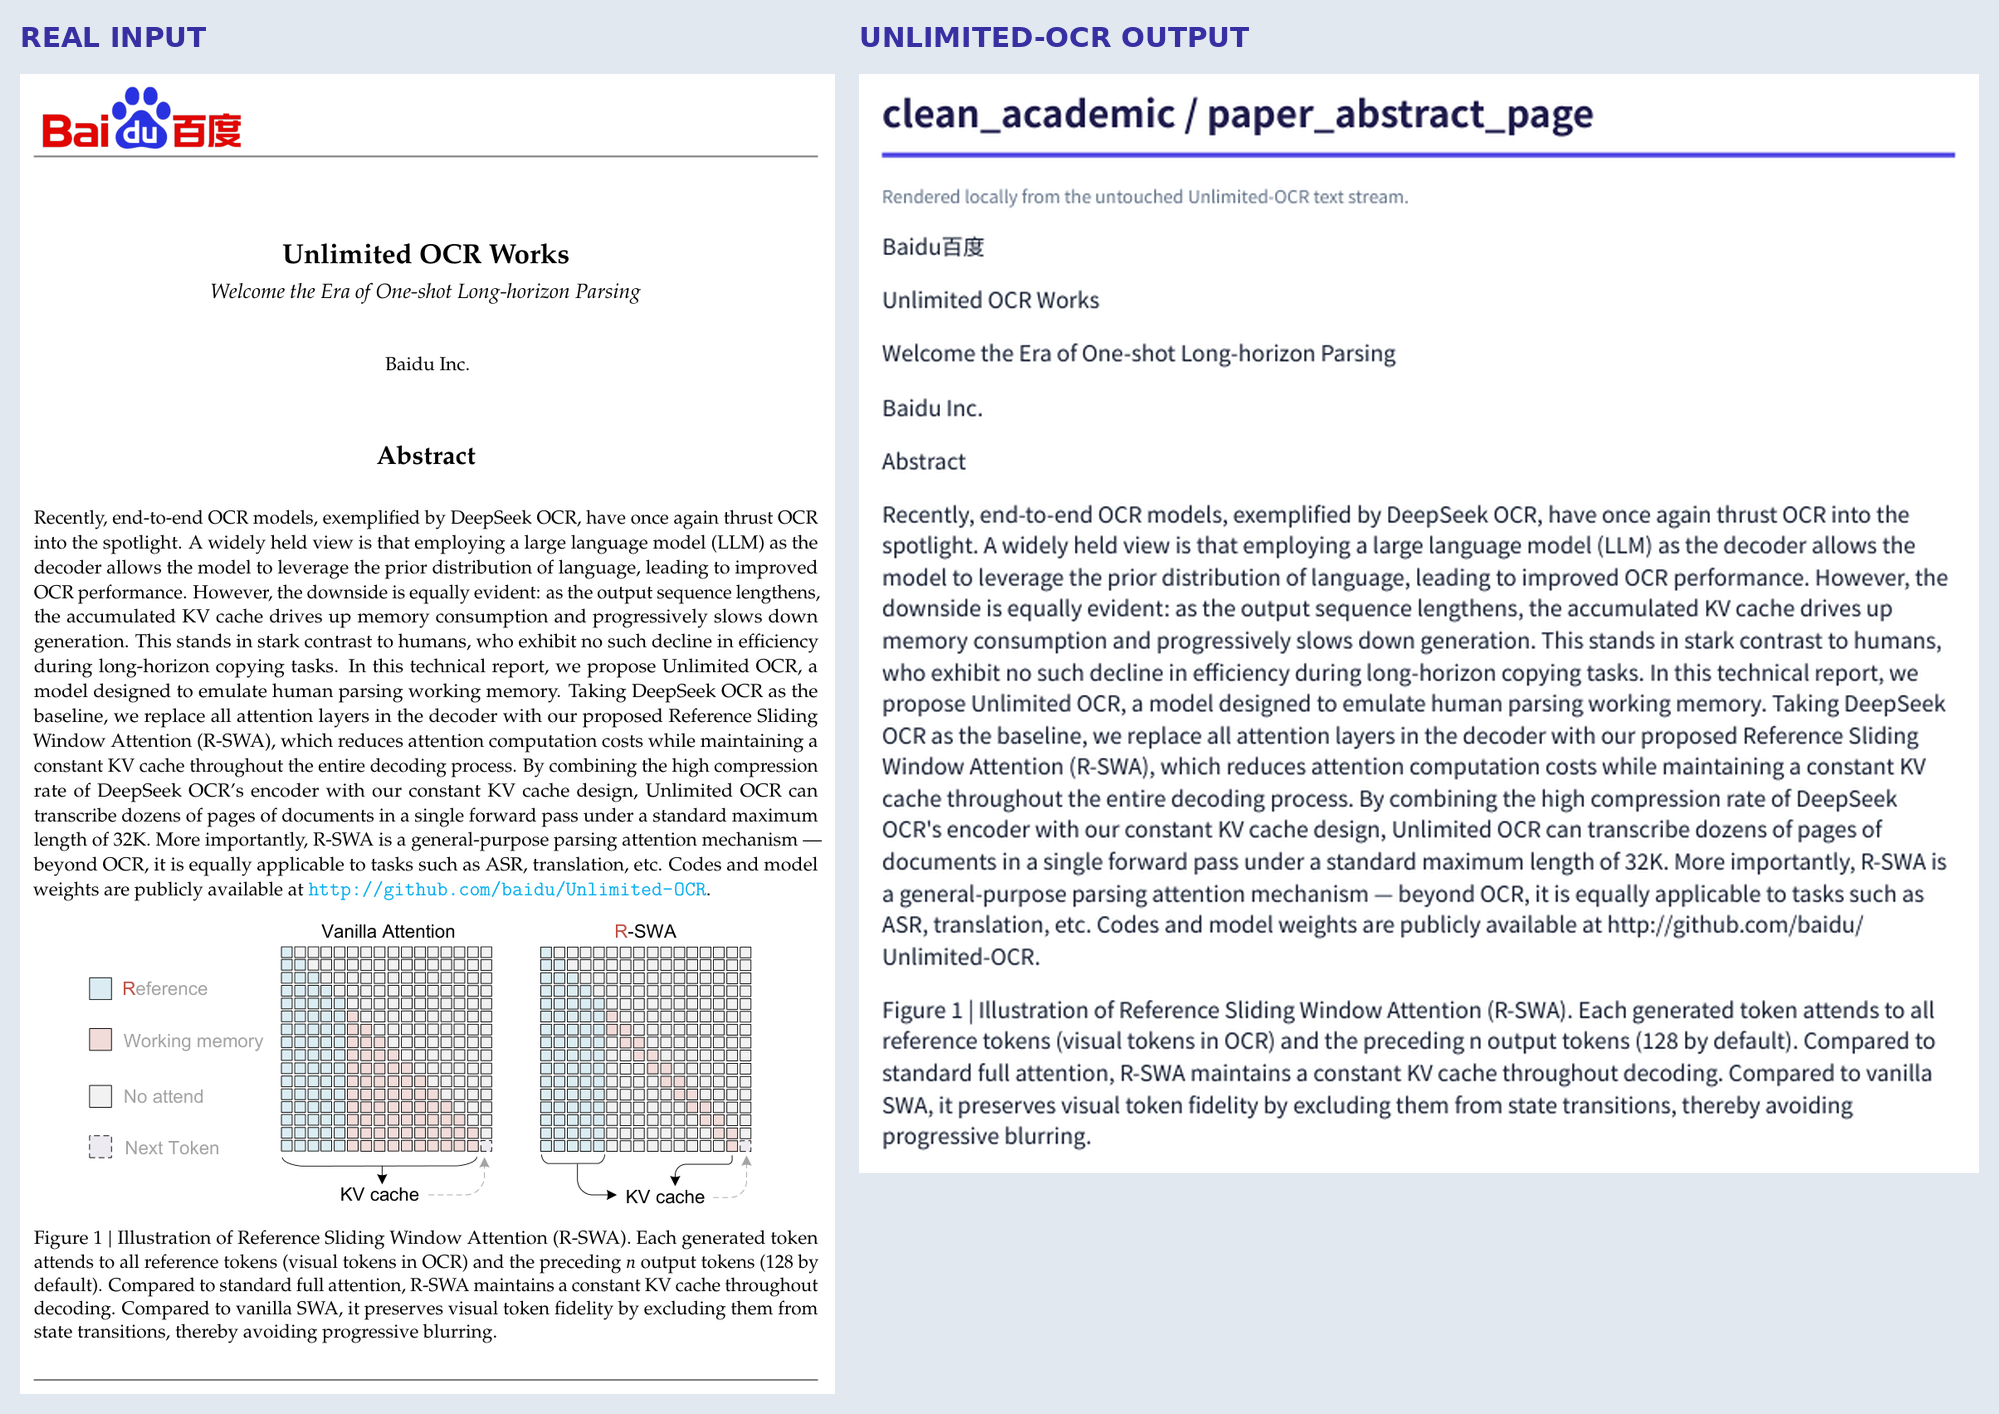
公式論文の1ページ目では、タイトル、著者、要旨、図のキャプションが順番に残りました。図の領域は検出されましたが、図中のラベルはテキストとして抽出されていません。本文の流れが自然でも、図まで読み取れたとは判断できない例です。
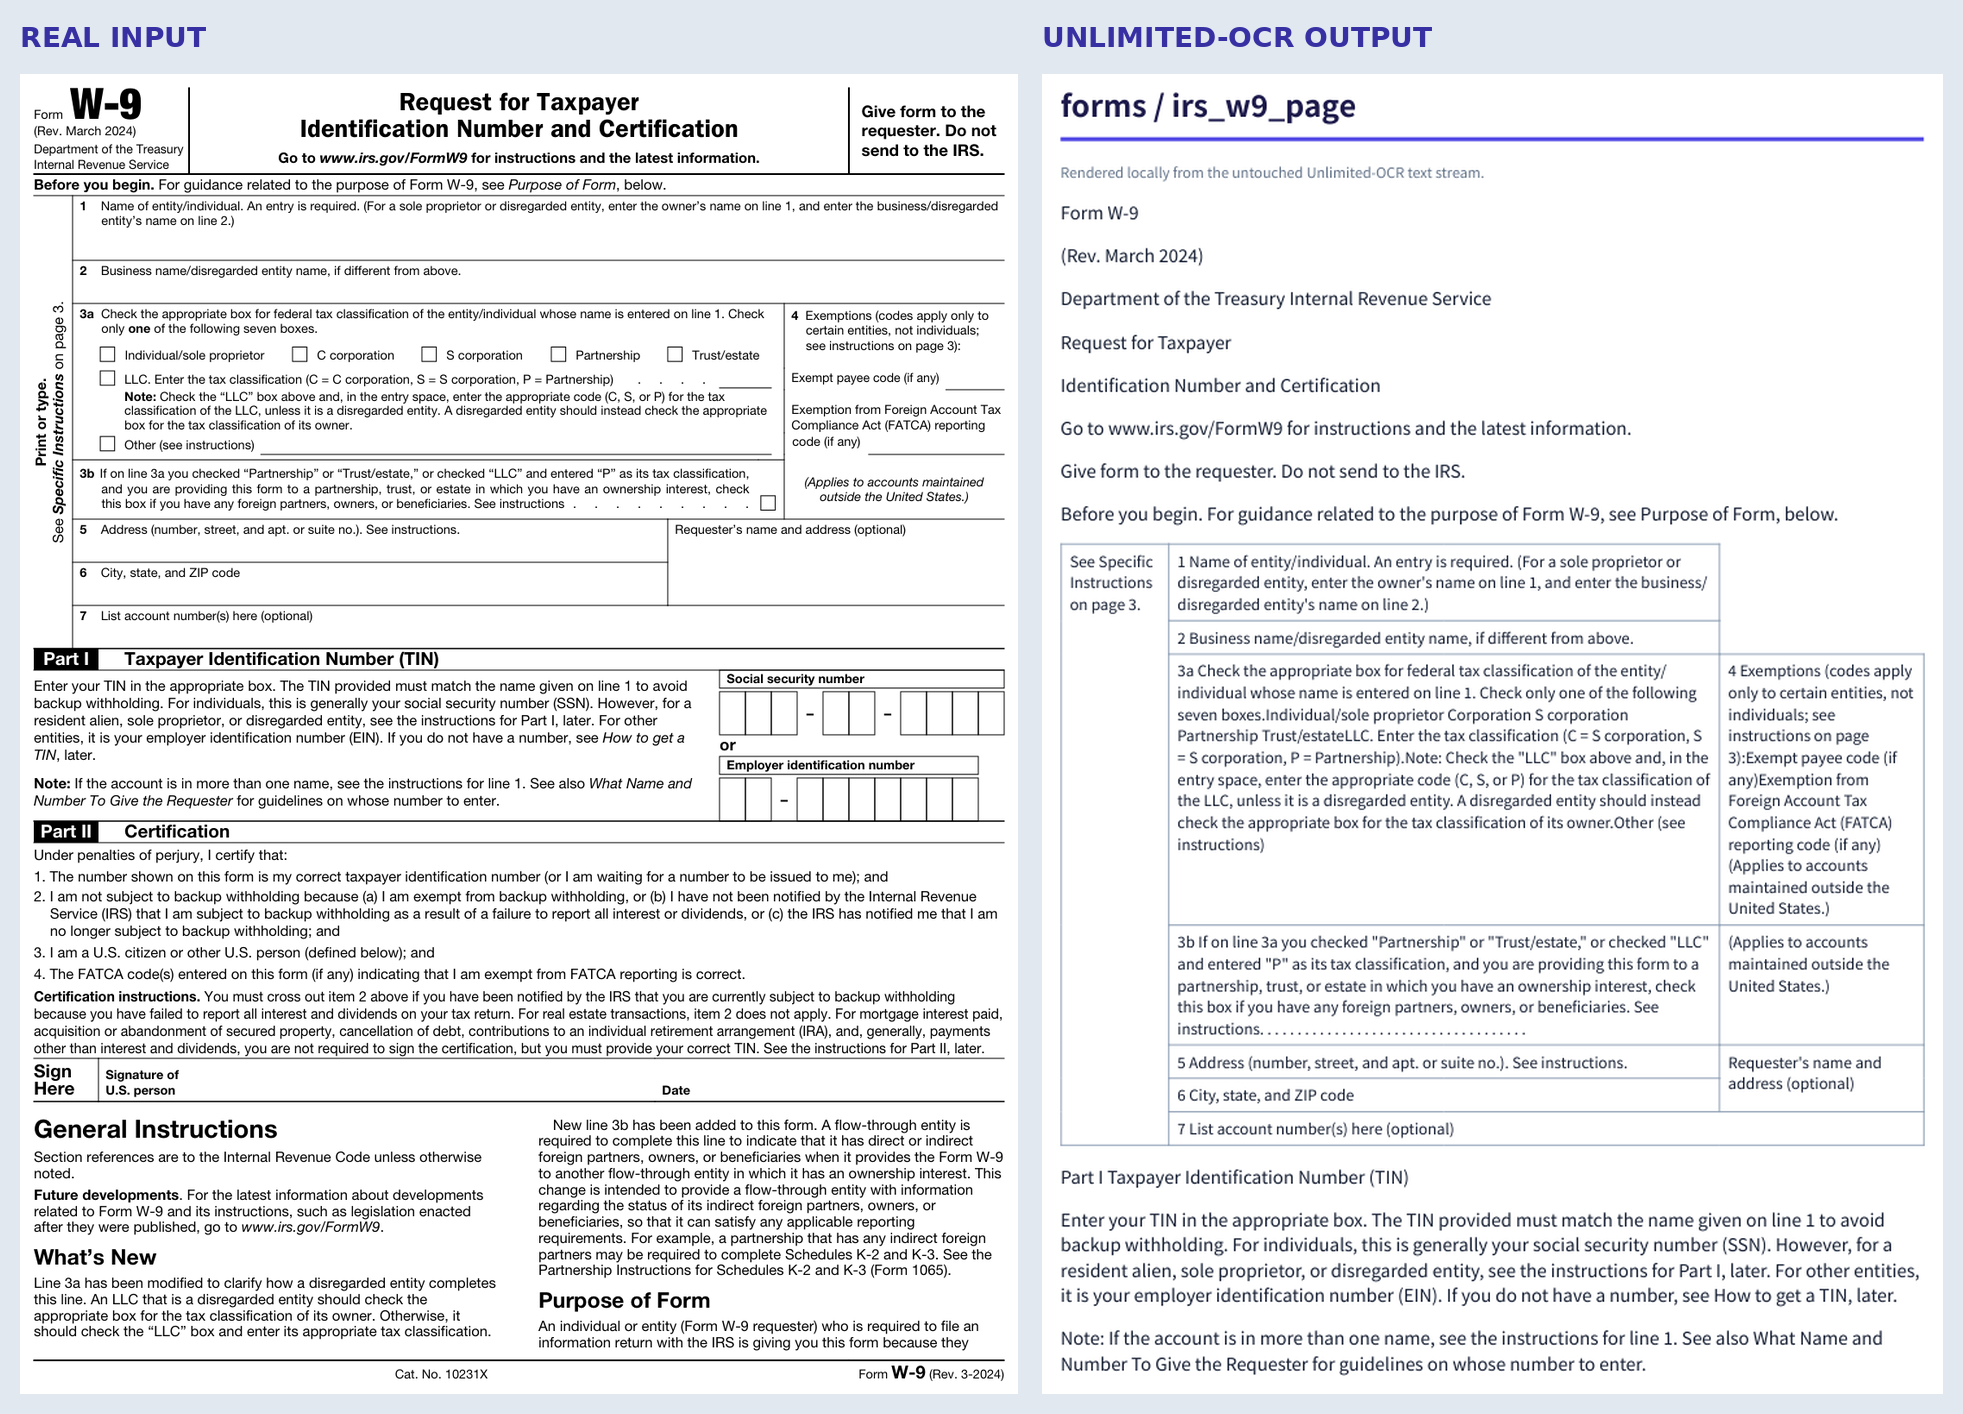
W-9フォーム:分類を取り違えた
IRSのW-9(2024年3月版) では、中央の罫線付き領域がHTMLの表として出力されました。ただし、LLCの分類を説明する箇所で次の置換が起きています。
- 入力
C = C corporation- 出力
C = S corporation
末尾の段落も途中で切れています。25/27項目が正しくても、残りの誤りが意味を変えるため、正解率だけで自動処理の可否は決められません。
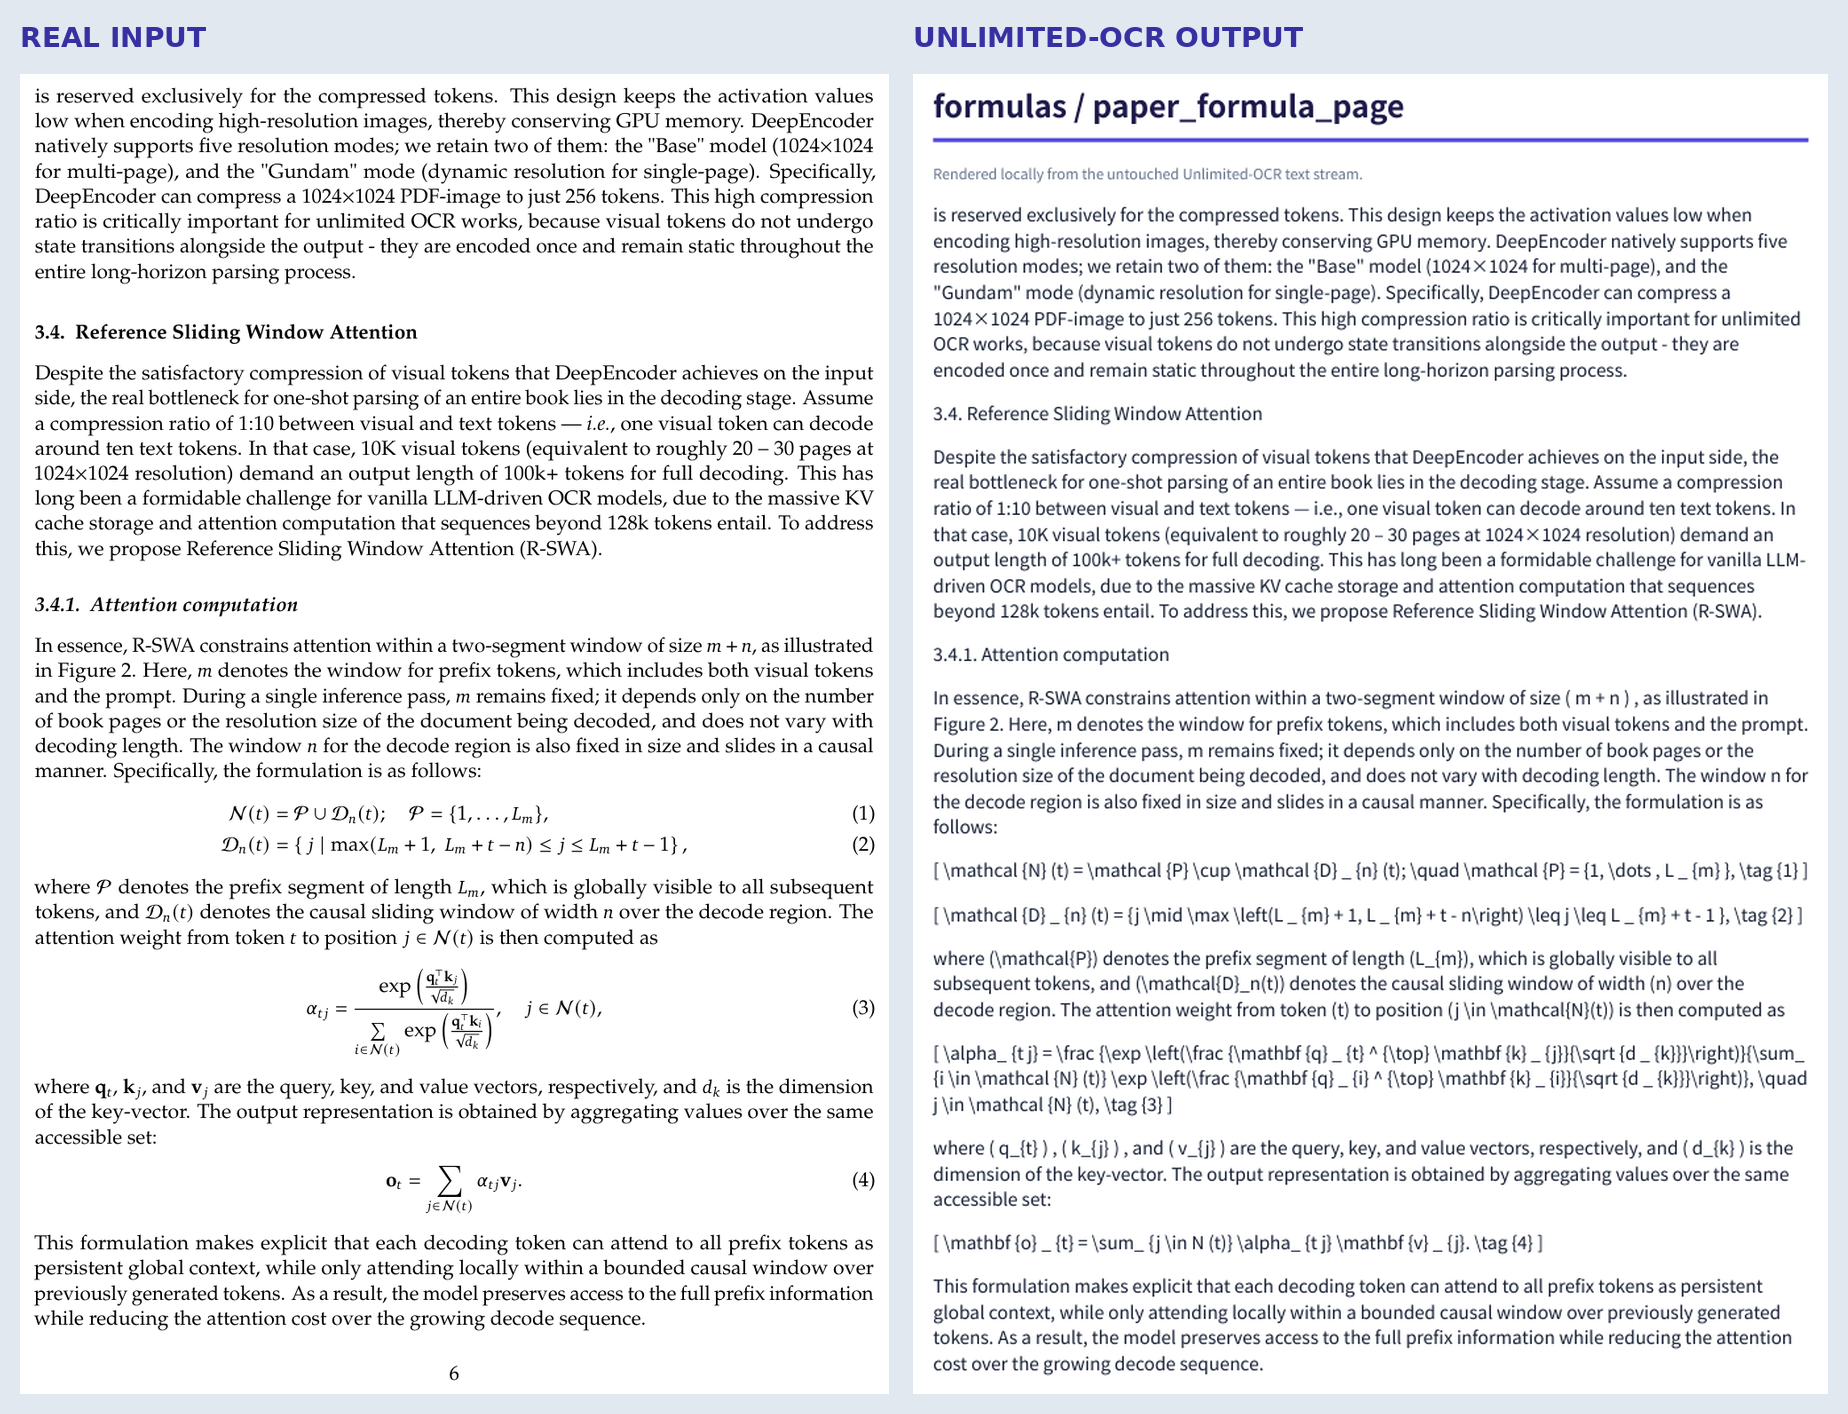
数式のページ:分母の添字が変わった
公式論文の6ページ目では、4つの数式が、数式を記述するLaTeXに近い編集可能な形式になりました。しかし式(3)の分母で、q_tがq_iに変わっています。
- 入力の分母
q_t^T k_i- 出力の分母
q_i^T k_i
書式として成立する式でも、添字が変われば内容は変わります。数式を文書や計算に再利用する前に、記号単位での照合が必要です。
新聞・手書き・写真で起きた欠落と追加
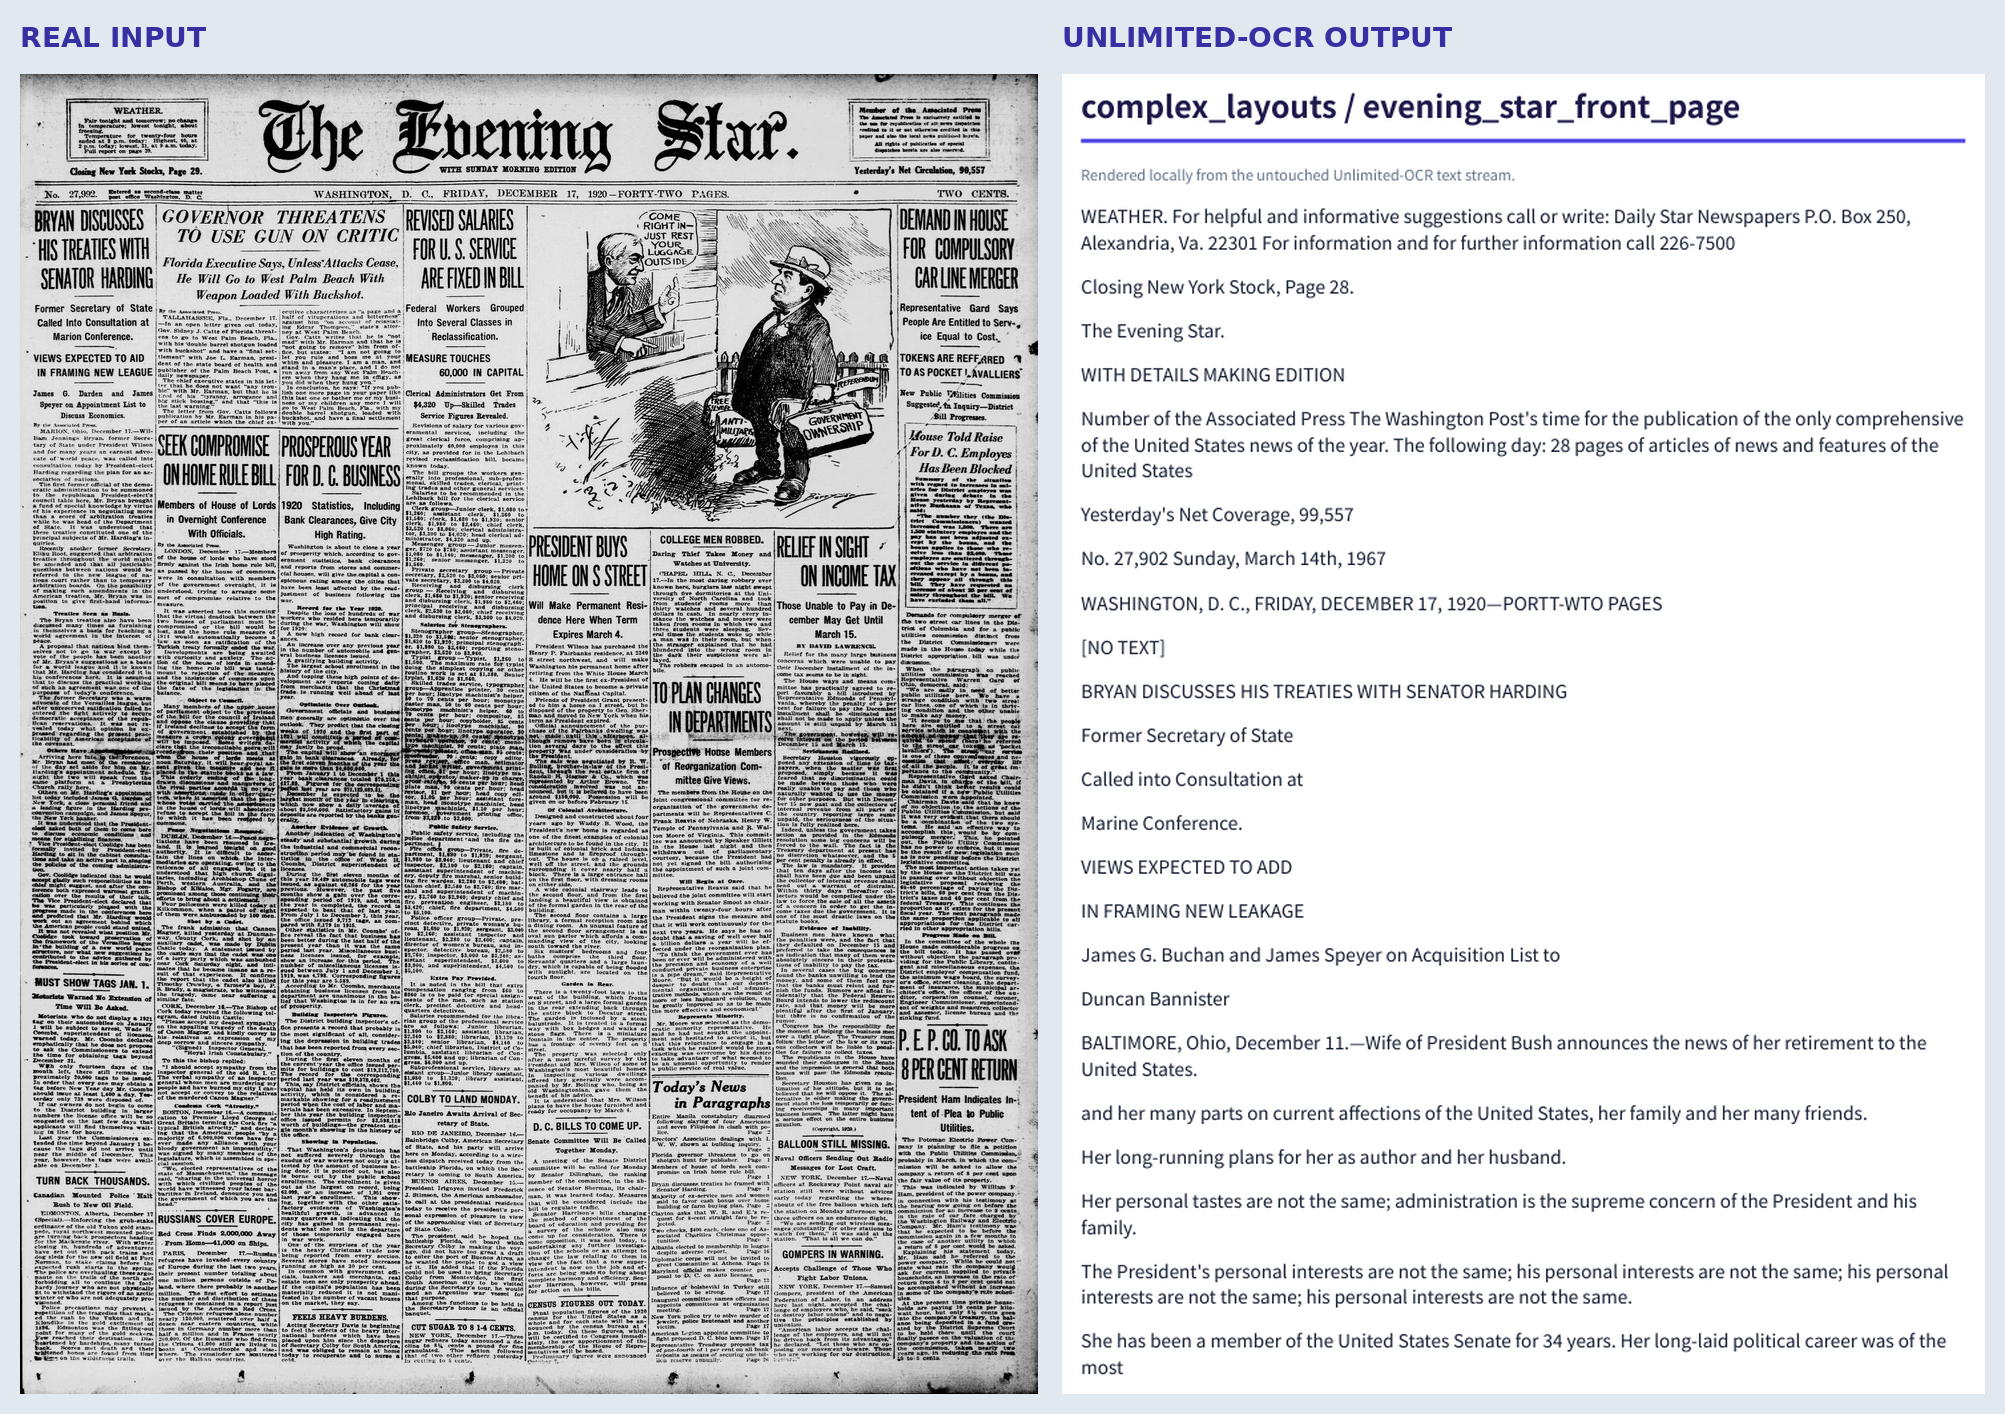
新聞:実在する見出しの後に別の文章が続く
1920年12月17日付Evening Starの1面 には、細かい段組み、罫線、図、劣化した印字があります。新聞名や一部の見出しは読めましたが、その後に元の紙面にない政治関連の文章や繰り返しが現れました。
流暢な文章が続くことは、転記の正しさを保証しません。3/15項目という結果と併せて、追加された文章がどこから来たのかを原本で確認する必要があります。
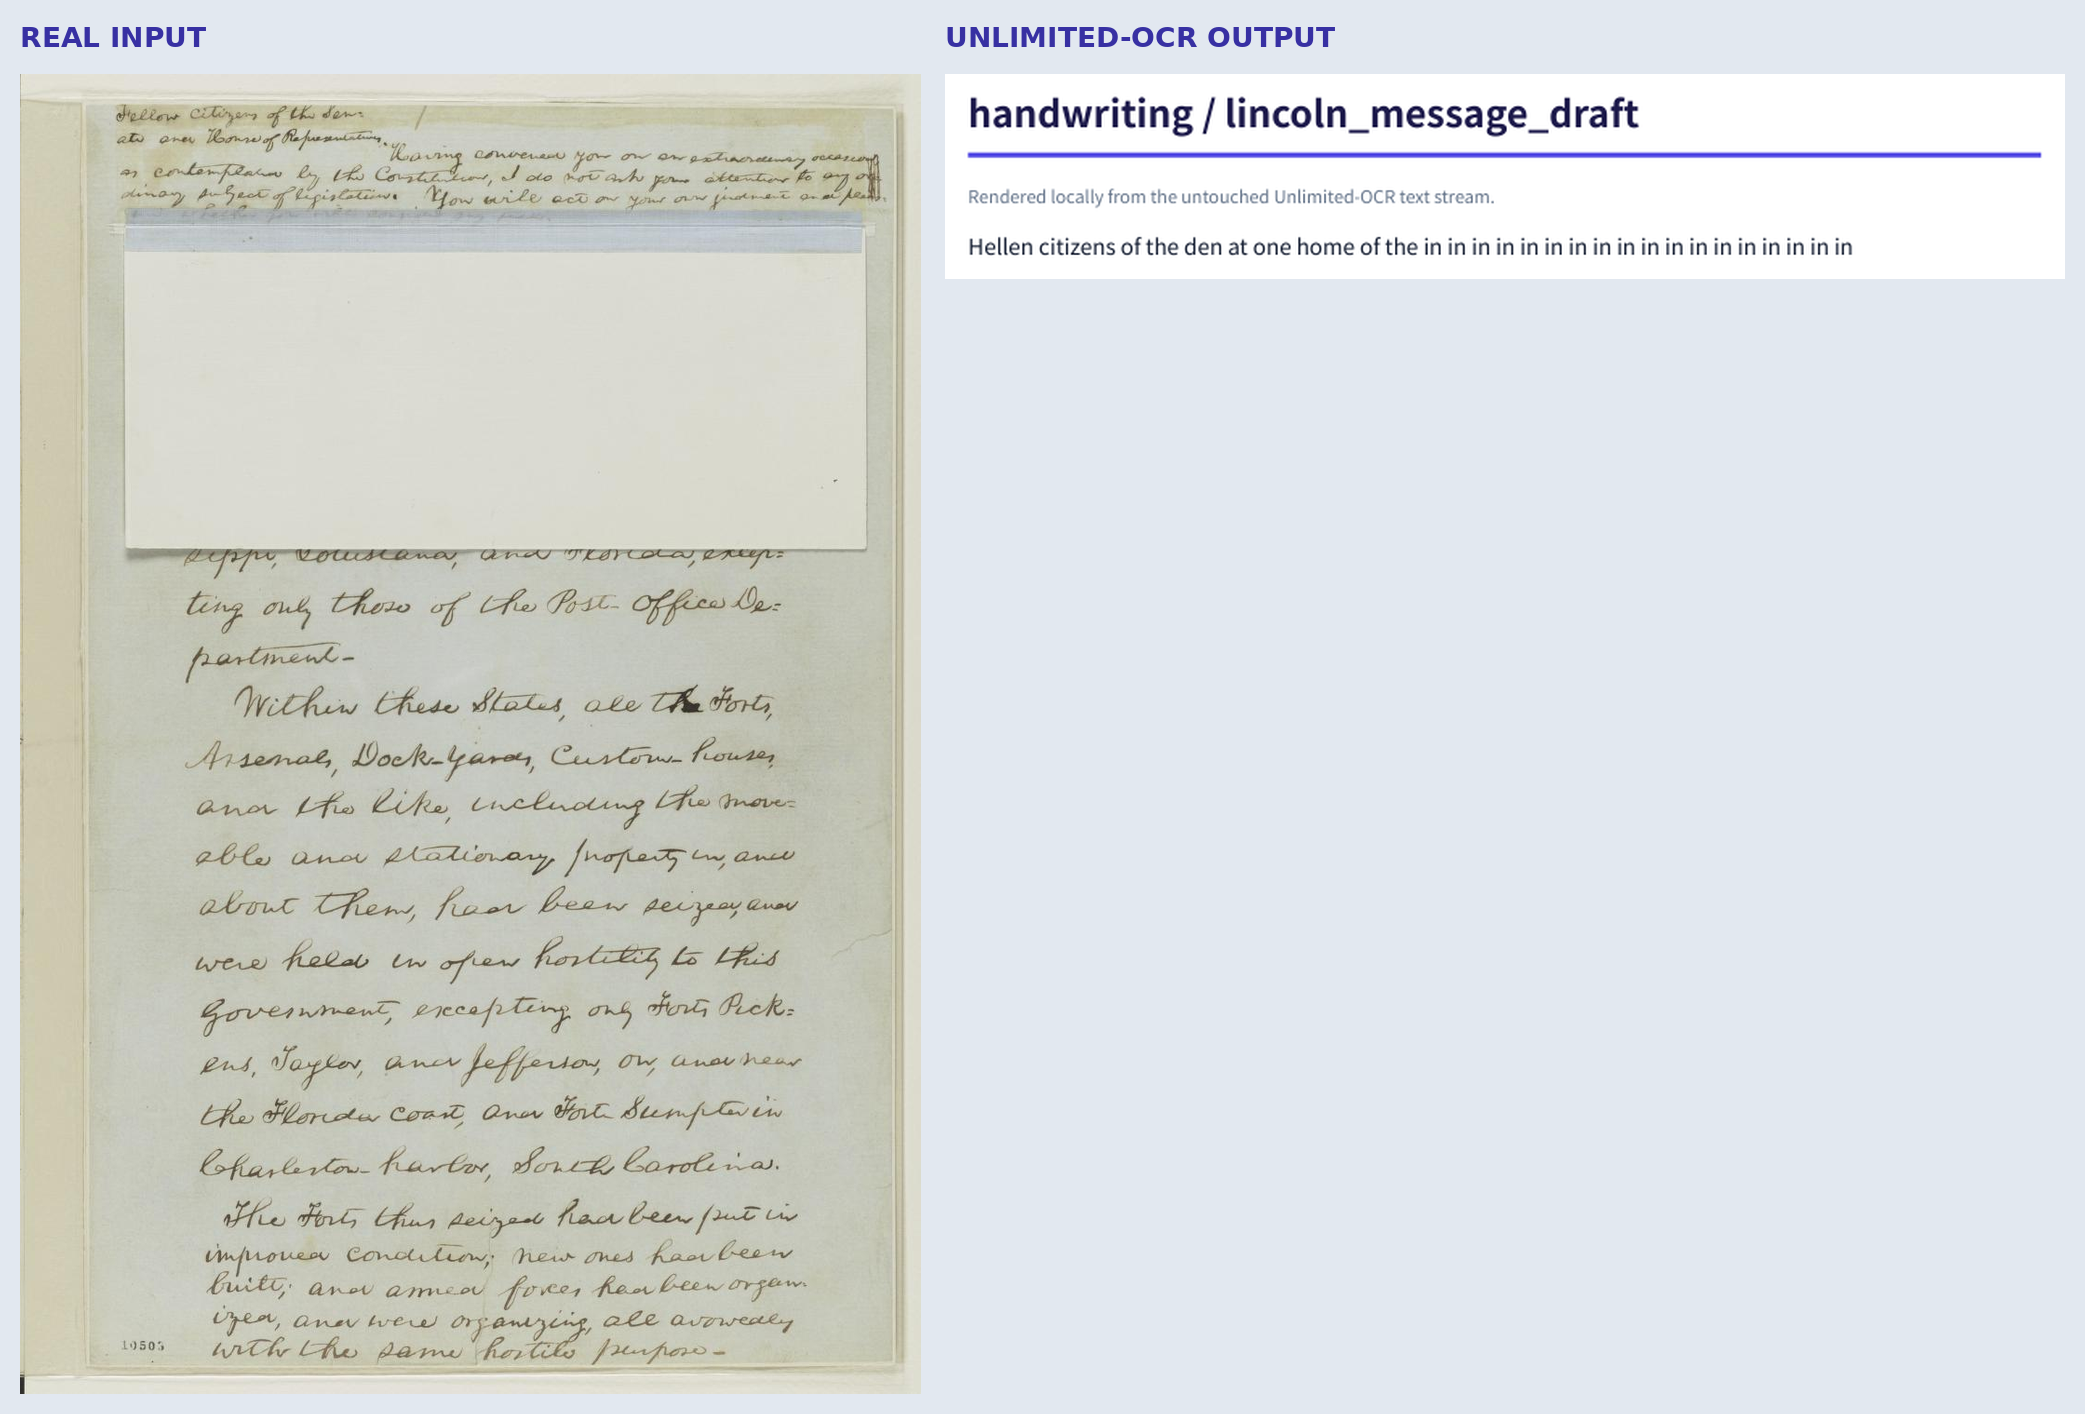
手書き:本文の大半が消え、短い語が反復
リンカーンの手書き原稿
では、薄い筆跡や続け字をほとんど読み取れませんでした。出力は壊れた短文とinの繰り返しになっています。15項目中0項目という数値は、この原稿1件での結果です。
レシート:別の日付と中国語が混入
プリペイド券の写真
では、日付、販売店番号、商品、券番号などの一部が残りました。一方、中国語の生物学に関する文が2回追加され、入力の2015年の日付と合わない2017年1月1日も出力されています。
この写真には中国語の原文がありません。したがって、追加された中国語は翻訳結果ではなく、入力に対応しない生成内容です。
多言語の看板:読めた行と壊れた文字列が混在
多言語で「ボタンを一度だけ押す」と書かれた看板 は、印刷文字に手書きの訳が重なった入力です。一部の行を認識した一方、上部の目立つ文字を落とし、文字列の崩れや長い数字列、分数の反復が現れました。
6/15項目の正解という集計から、個別言語の対応精度は推定できません。言語の違いに加え、筆跡、重なり、読順が同時に影響する例です。
PDFはページ数だけで成功を予測できない
2ページの文書は、各ページが1回ずつ正しい順序で現れました。本文、ページ番号、チェックリストも残り、チェックボックスの字形に軽微な差がある程度でした。
6ページの文書は最後まで出力されましたが、3ページ目が繰り返され、4ページ目が抜けました。 後半のページ番号や領域を示す記法にも崩れがあり、最後のページに到達したことだけでは完了と判断できません。
14ページの公式論文では、入力順に14個の<PAGE>区切りが出力されました。タイトル、要旨、手法、評価、結論、著者一覧、参考文献まで順序を保っています。ただし、ページ順が正しくても、細かい図中の文字や数式の記号がすべて正しいという意味ではありません。
異なる文書を使った3件の結果なので、「14ページまでなら安全」「6ページ以上は失敗」といった境界にはできません。ページ数、順序、各ページの内容を、それぞれ入力と照合します。
業務で使うなら原本との対応を残す
表・数式・座標を後の確認に使う
出力には、文章に加えて、タイトルなどの領域ラベル、位置を表す座標、HTMLの表、LaTeXに近い数式、<PAGE>区切りが含まれます。たとえば次のように、領域の種類と位置が文字列に添えられます。
<|det|>title [55, 32, 674, 69]<|/det|>Unlimited OCR Works原本、加工前の出力、整形したテキストを同じ文書IDで結び付けておくと、疑わしい箇所を確認しやすくなります。検索用のテキスト化や数式の下書きに使う場合も、出力だけを保存せず、ページへの参照を残す運用が役立ちます。
欠落・置換・反復・追加を別々に点検する
今回の誤りは、図中の文字やページの欠落、分類や添字の置換、語句やページの反復、原本にない文章の追加に分けられます。見た目が整っているかだけを確認すると、これらを見落とします。
実際に扱う帳票や撮影画像で、正しい出力の基準を先に決めてください。金額・日付・分類・数式は項目ごとに照合し、複数ページでは入力と出力のページ対応を確認します。手書きや劣化画像は、今回の結果から特に慎重に評価すべき対象です。
結論:整った文書にも照合の工程を
元の検証は10条件を、構造と内容に分けて評価しています。構造は「成功5・一部問題2・失敗3」、内容は「成功2・一部問題3・失敗5」でした。「成功」は主要な結果を保てた場合、「一部問題」は有用な出力に記録された誤りが残る場合、「失敗」は欠落・反復・追加によって結果が崩れた場合です。これらは原記事の定性的な判定で、上の114項目の正解率とは別の指標です。
Unlimited-OCRは、整ったページの表・見出し・数式を取り出す候補になります。ただし、認識した内容を業務に引き渡す前には、原本と照合する工程を組み込んでください。今回の例では、構造を保てたW-9や数式にも、意味を変える誤りが残っています。
出典と関連する検証
- VoicePingの元の実測記事 :集計値、実行条件、比較画像の根拠。
- Unlimited OCR Works論文 、公式コード 、公式モデルカード :設計と推論方法。
- 5言語・900ページのOCRベンチマーク :別のデータ・評価方法による比較。今回の重要項目正解率と数値を直接比較しないでください。
スキャン文書ではなく録音・動画を扱う場合は、VoicePingのファイル文字起こし で、元の音声を参照しながら文字起こしや翻訳を進められます。入力する資料に応じて、文書認識と音声認識を使い分けます。