この記事の内容
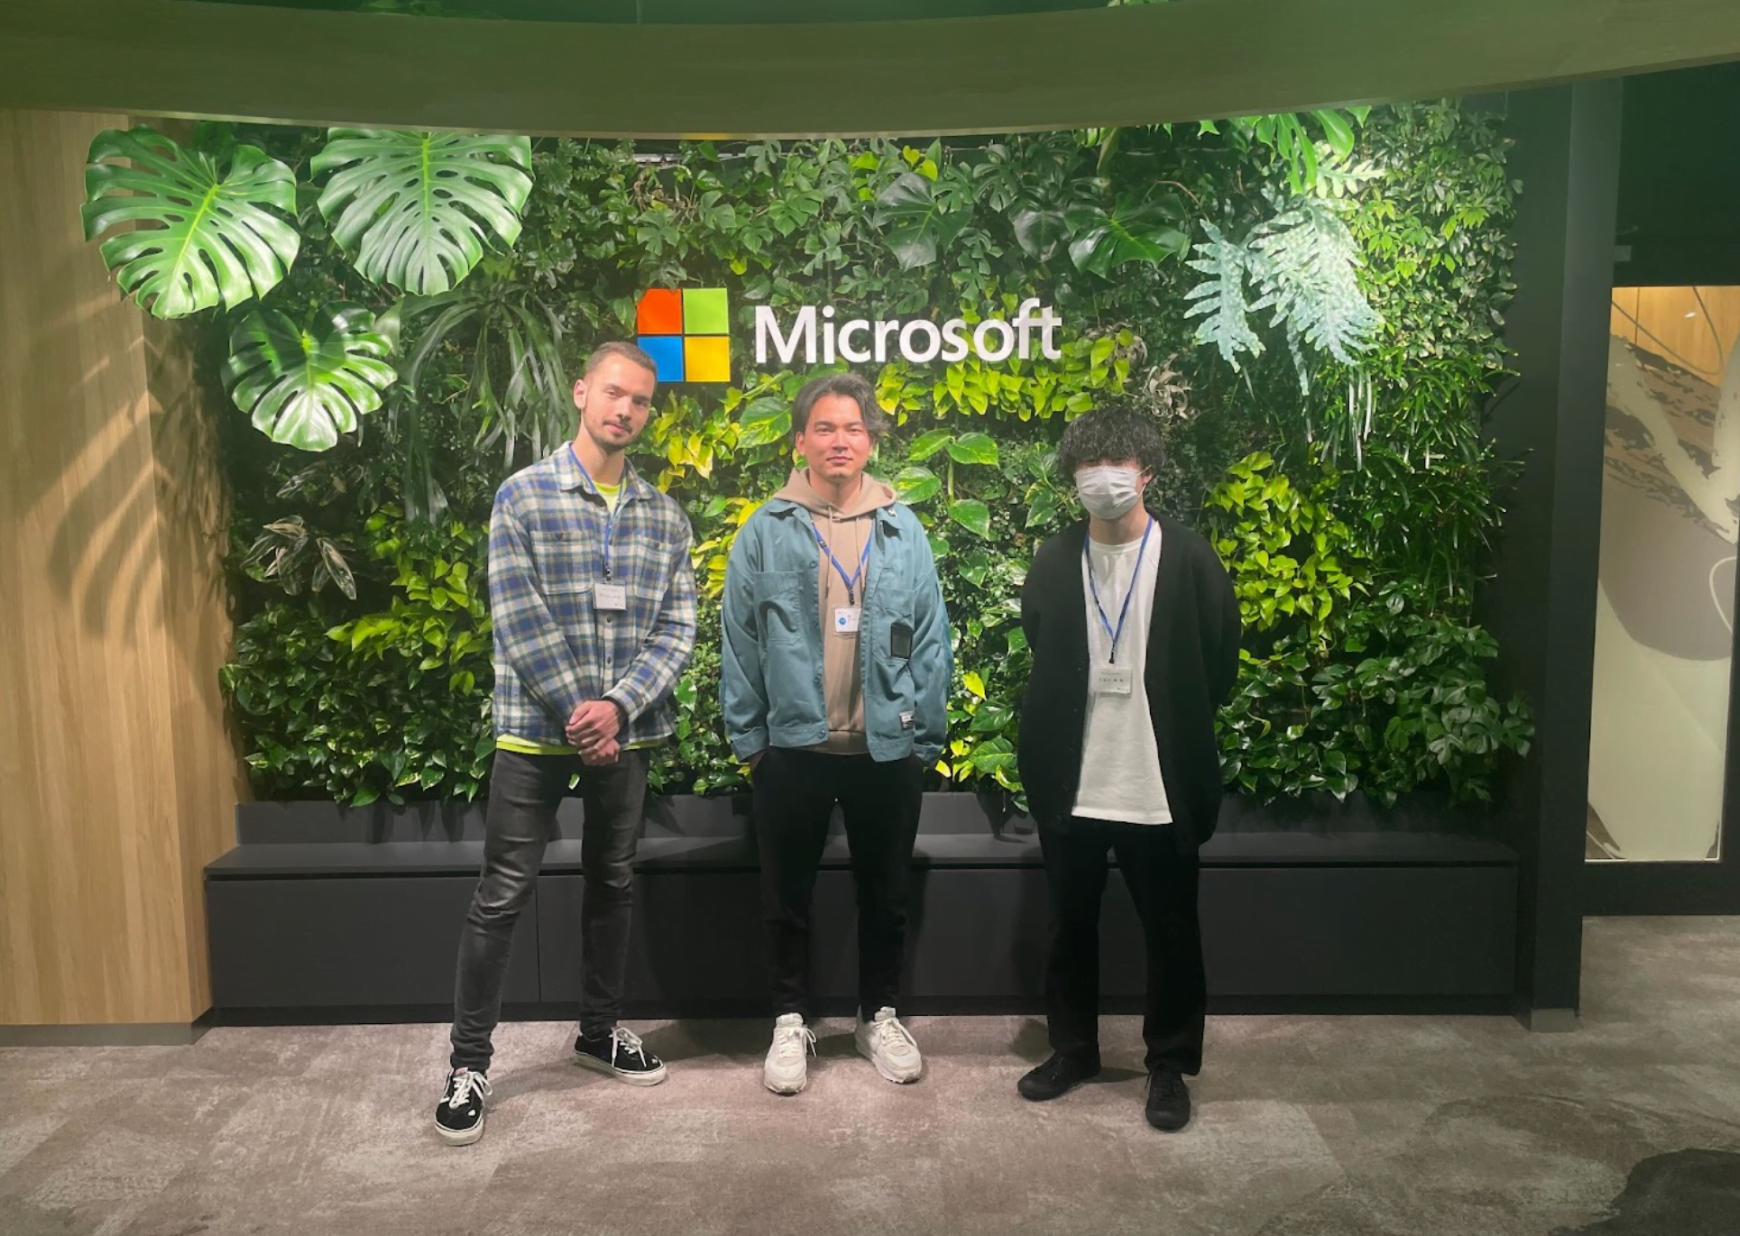
データを集めるところから、分析や機械学習で使うところまでを実際に体験する。 VoicePingの開発メンバー3名は、2023年に「OpenHack for Lakehouse」に参加し、Azure Databricksを使った2日間の演習に取り組みました。
当時の案内にはMicrosoft、ZEAL、Databricksの共催と記載されています。この記事では、データの準備、モデルの作成やモニタリングを通して学んだ内容と、参加直後の感想を紹介します。
Azure Databricksとデータ処理
Azure Databricks は、データの取り込みや加工、分析、機械学習に使うツールをまとめたクラウド上の基盤です。Apache Sparkなどの技術を使い、開発者やデータを分析する人が共同で作業できます。
今回学んだ考え方の一つが、データを段階的に整える「メダリオンアーキテクチャ」です。データの品質や用途に応じて、主に次の三つの層に分けます。
- Bronze(ブロンズ):取り込んだ未加工のデータを保持する層。
- Silver(シルバー):誤りや重複を確認し、分析に使いやすい形に整える層。
- Gold(ゴールド):業務の目的に合わせて集計し、レポートや分析に使う層。
Microsoft Learnの解説 でも、この構造は推奨される設計パターンであり、必須ではないと説明されています。データをどう整理すれば使いやすくなるかを考えるための枠組みです。
演習した三つの領域
2023年の演習では、当時の「Data Science & Engineering」「Machine Learning」「SQL」という三つのモードを使いました。以下はその際の体験です。現在の画面構成は変わっているため、操作する際は現行のワークスペース案内 を確認してください。
Data Science & Engineering
まず、データを取り込み、加工して分析に使える状態にする作業を学びました。データを準備する段階が、その後の分析や機械学習につながっていることを、演習全体を通して確認しました。
Machine Learning
準備したデータを使い、機械学習モデルのトレーニングやデプロイを体験しました。モデルを作る作業まで進むことで、前段階でデータを整える意味も理解しやすくなりました。
SQL
SQLは、データから必要な情報を取り出したり、集計したりするための言語です。演習ではSQLによる分析にも取り組み、データの処理から結果を確認するところまで、一連の流れを学びました。
学習内容を振り返る資料として、Microsoftが公開しているOpenHack for Lakehouseの日本語教材 もあります。リンク先は当時の版で、データの各層、SQL、機械学習に関するノートブックが含まれています。
参加者が持ち帰った学び
普段のWeb開発とは違う領域に触れたことで、何が見えたのでしょうか。以下は、参加直後に寄せられた感想の要旨です。担当分野も当時のものです。
相田:データ処理への第一歩
モバイル・Web開発を担当する相田は、Web系の開発経験を中心に仕事をしてきたため、データエンジニアリングを深く学ぶ機会になったと振り返りました。ビジネス上の課題に沿って手を動かし、Azure Databricksを使ったデータ処理や機械学習モデルの作成を学べた点が印象に残ったとのことです。
次郎丸:データを使える状態にする
Web開発を担当する次郎丸は、データサイエンスやデータエンジニアリングの知識を得られた点を挙げました。データは、そのまま保有しているだけでは仕事に使えません。使える状態にするための作業を具体的に学べたことが、技術とビジネスの両面での気付きになりました。
学習を製品開発につなげる
今回の2日間は、日常の開発では触れる機会が少なかったデータ処理の流れを、まとめて学ぶ機会になりました。AIを使う製品を考えるうえでも、入力するデータを理解し、扱える状態に整える知識が土台になります。
VoicePingでは、チームで新しい技術を学び、製品開発にどう生かすかを考える機会を大切にしています。現在のVoicePingバーチャルオフィス の使い方や機能は、製品ページで紹介しています。