この記事の内容
VoicePingが目指すのは、役に立つ仕事をこなし、その仕事の変化にも適応する知能ロボットです。 ある作業で得た知識を次の作業に生かし、新しい用途ごとに必要なデータ、再学習、開発の手間を減らしたいと考えています。その実現に向け、まずSO-101アームを使って認識・計画・制御を研究しています。
2026年9月18日までに確認できた成果は、人の実演を解釈してシミュレーション内で実行したことと、それとは別に、物を置く動作を2回続けてシミュレーションで実行したことです。実機の立ち上げ、実機への転用の成功、より幅広いスキルの学習は、まだ検証できていません。
ロボットは、どのような変化に適応すべきか
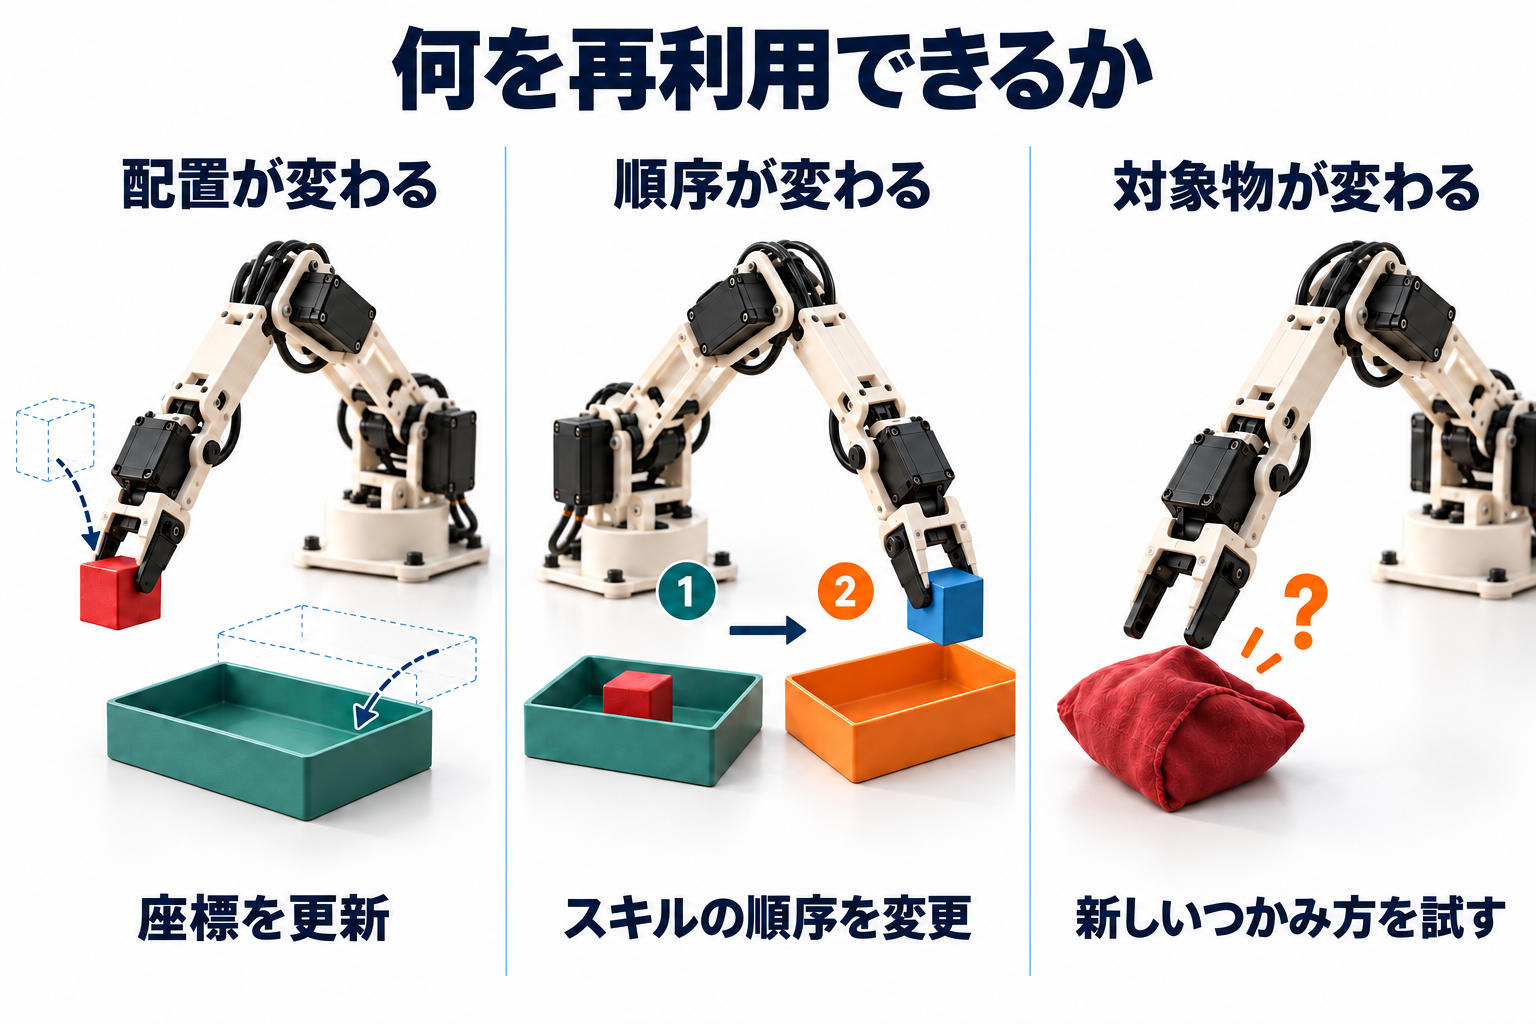
作業台で部品をトレイに仕分けるロボットを想像してください。トレイが動けば、座標の更新が必要です。既知の配置作業を違う順番で頼まれたら、既存のスキルを組み合わせ直します。形や材質が変われば、別のつかみ方や追加の経験が必要になるかもしれません。課題は、何が変わったのかを見極め、引き続き使えるものを再利用することです。
Open X-Embodiment は、複数のロボットプラットフォームの経験を集めることで、物体操作の方策を改善できることを示しています。私たちが再利用を研究する動機の一つですが、自分たちのシステムでどれだけ改善するかは、これから計測する必要があります。実用化で問われるのは、変化のたびに、設定作業、新しいデータ、人の支援がどれだけ必要になるかです。
なぜSO-101から始めるのか
SO-101は機械設計が公開 され、LeRobotにも対応 しているため、物体操作の一連の流れを研究しやすいプラットフォームです。卓上で物を置くだけでも、物体の識別、位置の把握、接触、結果の確認が必要です。条件を一つずつ変え、どこで失敗するかを調べられます。
アームを実際に動かすと、モデルの評価だけでは見えない制約も分かります。カメラの設置位置、機械の挙動、実験記録の質などです。より大型のプラットフォームを選ぶ前に、再利用できるソフトウェアと実践的な判断力を育てられます。次に選ぶハードウェアは、用途に必要な可動範囲、可搬重量、環境、信頼性から決めるべきだと考えています。
主要なロボティクスプラットフォームから学ぶこと
以下の事例は、商用システムへの組み込みから研究、工場での試行まで、ロボティクスの異なる領域を扱っています。一次資料の確認日は2026年9月24日です。市場シェアや性能の順位を示す比較ではありません。
システム統合
Universal Robots
AI Accelerator
注文受付中作業全体の流れを評価する
設定・作業の成功・障害の診断
センシングと制御
Franka Research 3
研究用アーム
研究用ハードウェア研究課題に合う機体を選ぶ
精密な力制御の研究には、別のアームが必要な場合があります。
ロボット向けモデル
Google DeepMind
Gemini Robotics 2 / ER 2
プレビュー版モデルER 2の利用:Google AI Studio / Gemini API
推論と動作を分けて検証する
その後、実機で組み合わせを検証します。
現場への導入
BMWでのFigureの取り組み
Figure 03 + Helix 02
生産現場でのプロジェクトHelix 02:全身制御(Figure発表)
現場の作業を一通り検証する
工場でのプロジェクトには、明確な対象範囲があります。
- 目標を具体化する
- スキルを再利用する
- 適応を計測する
システム全体をどうつなぐか
実演や指示から目標を得て、認識が対象物の位置を特定し、計画が利用可能なスキルを選んで順序を決め、制御が動作を生み出します。実行中は新しい観測を取り込み、結果を確認して、続行、再試行、人への支援要請を判断します。役割を分けることで、各要素の問題を特定し、改善できます。
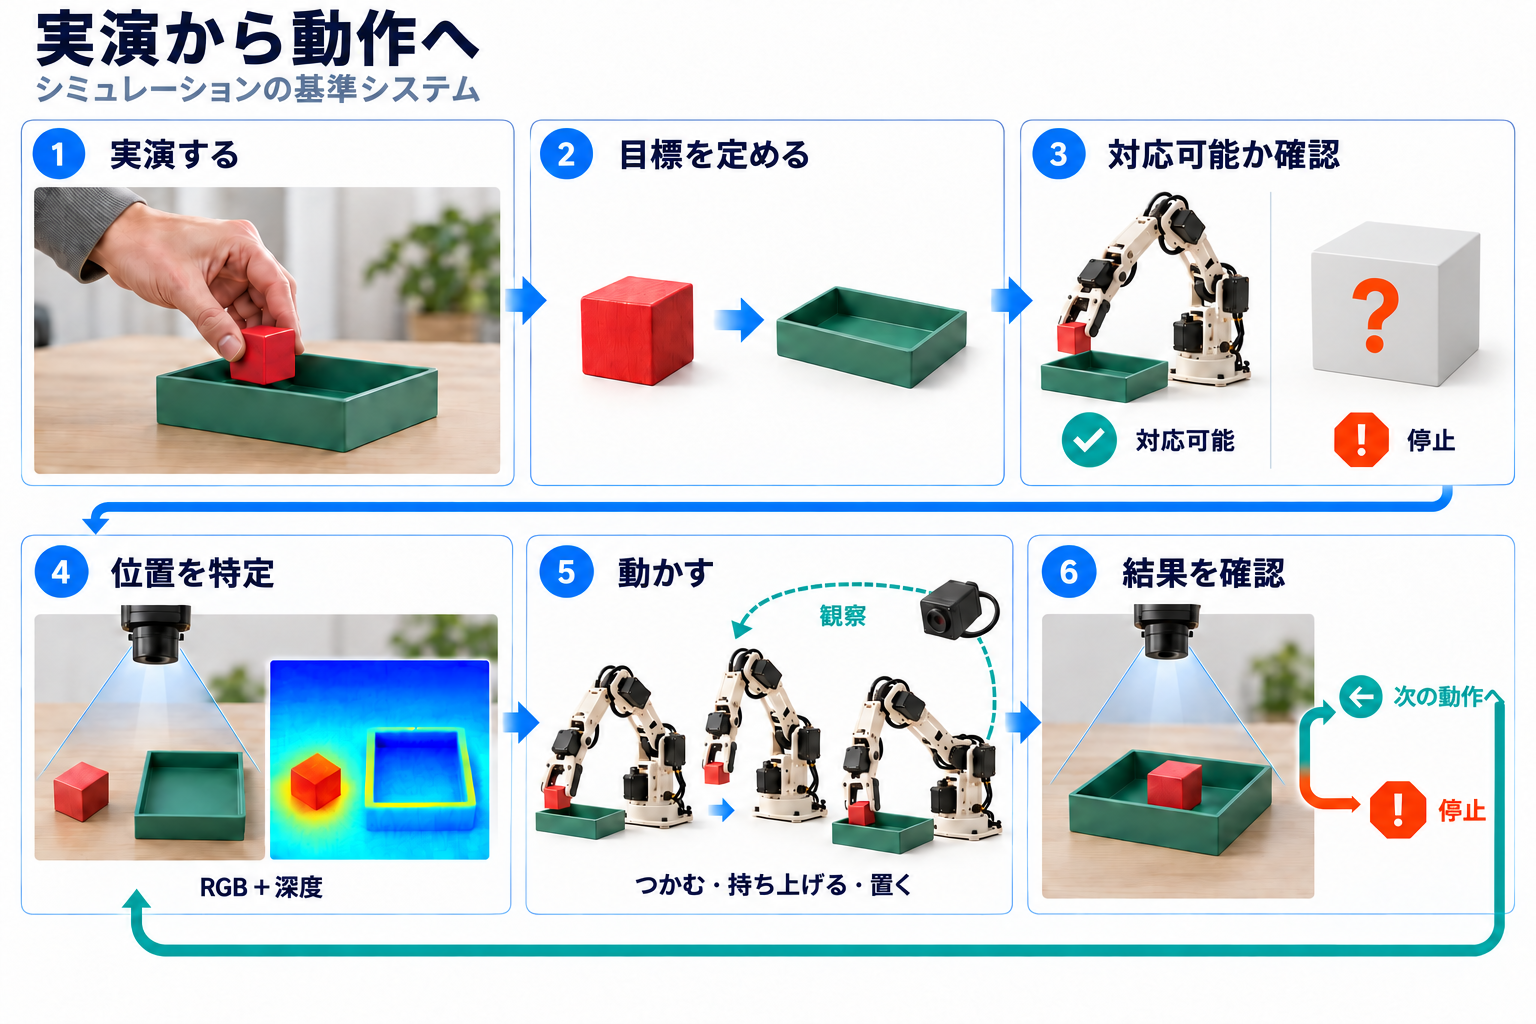
現在のシステムは、短い人の実演動画を、対応可能なピックアンドプレースの目標として解釈し、プログラム済みの幾何学的な動作スキルを呼び出します。この動画で新しい物体操作の方策を学習するわけではありません。 この基準システムを比較対象として、学習による認識、方策、作業の組み合わせを評価します。リアルタイムの認識に基づく安定した実行は、まだ課題として残っています。
シミュレーションと実機を相互に改善する
シミュレーションでは、実機試験の前に作業を繰り返し、条件を変え、手法を比較できます。一方、実機では、照明や遮蔽、カメラの校正、接触時の挙動、応答の遅れなど、シミュレーターで捉えきれなかった点が明らかになります。その計測結果を、シミュレーター、制御器、学習過程に戻して改善する必要があります。
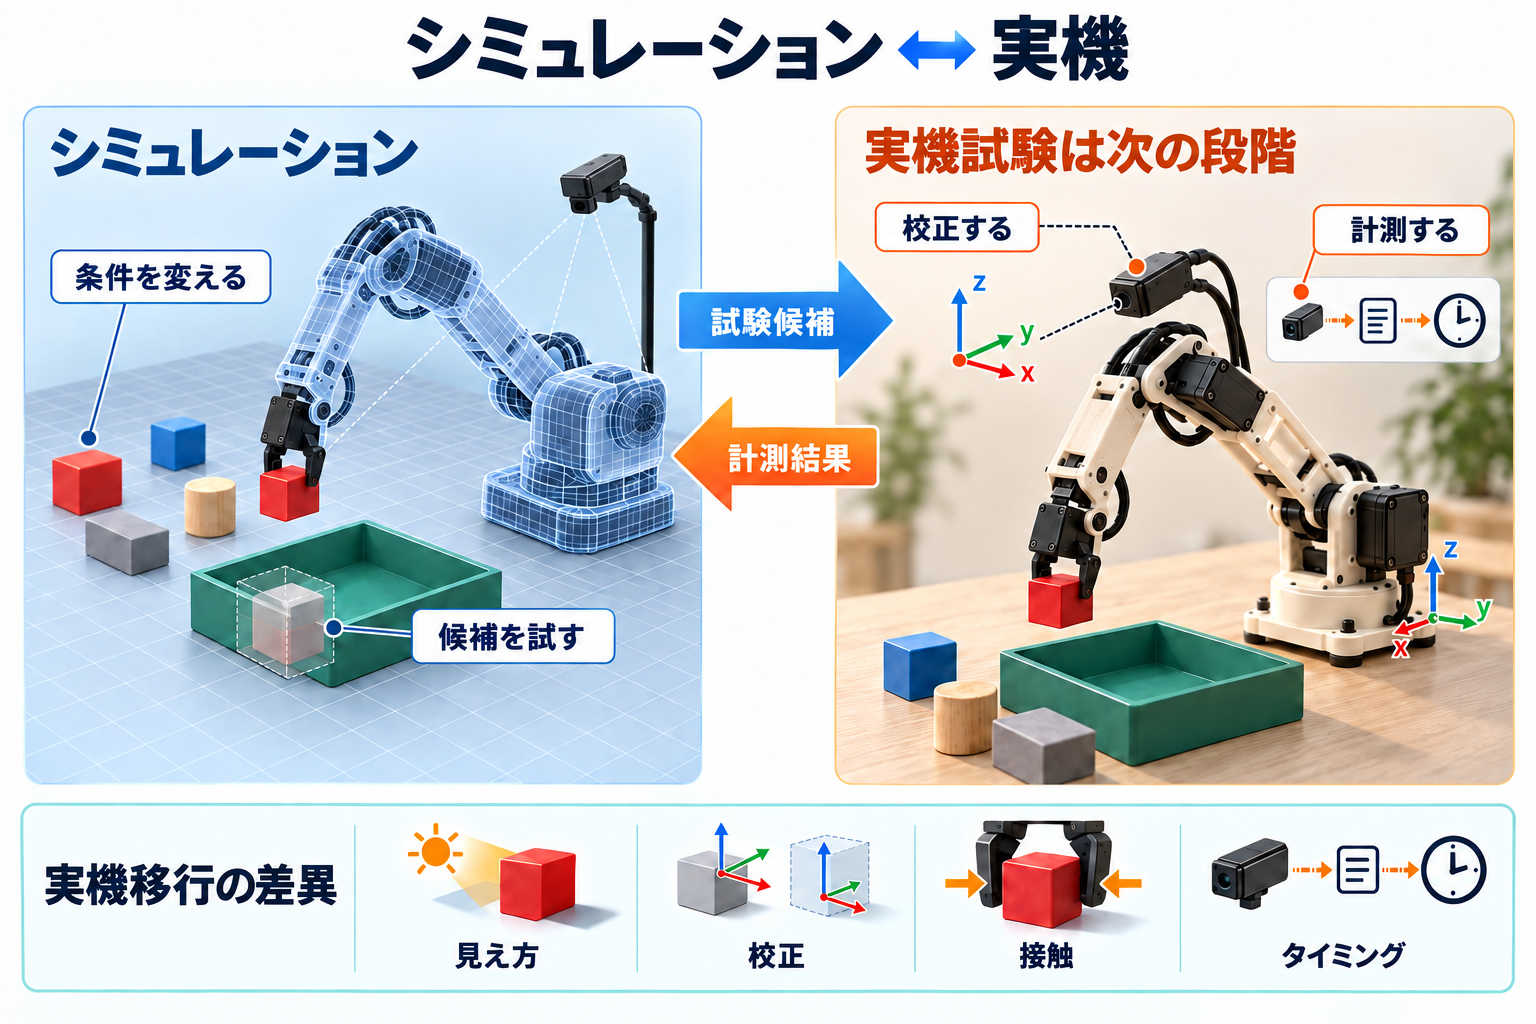
関連する手法にドメインランダム化 があります。シミュレーション内の見え方を変えることで、特定の視覚条件への依存を減らす手法です。元の研究が示したのは物体位置の推定における実機への転用であり、あらゆるロボット動作が自動的に転用できると示したわけではありません。自分たちのシステムを評価するには、校正済みの実機で試験し、期待した挙動と観測した挙動を比較する必要があります。
進捗をどう測るか
作業が成功したかどうかと、ロボットが成功したと判断したかどうかは、別々に測ります。私たちのシミュレーションでは、物体を正しい場所に置けても、画像による確認に失敗することがあります。独立した物理状態のチェックにより、こうした確認の誤りと、把持や配置の失敗を区別できます。評価側が使う正解の状態情報を、制御器に渡すことはありません。
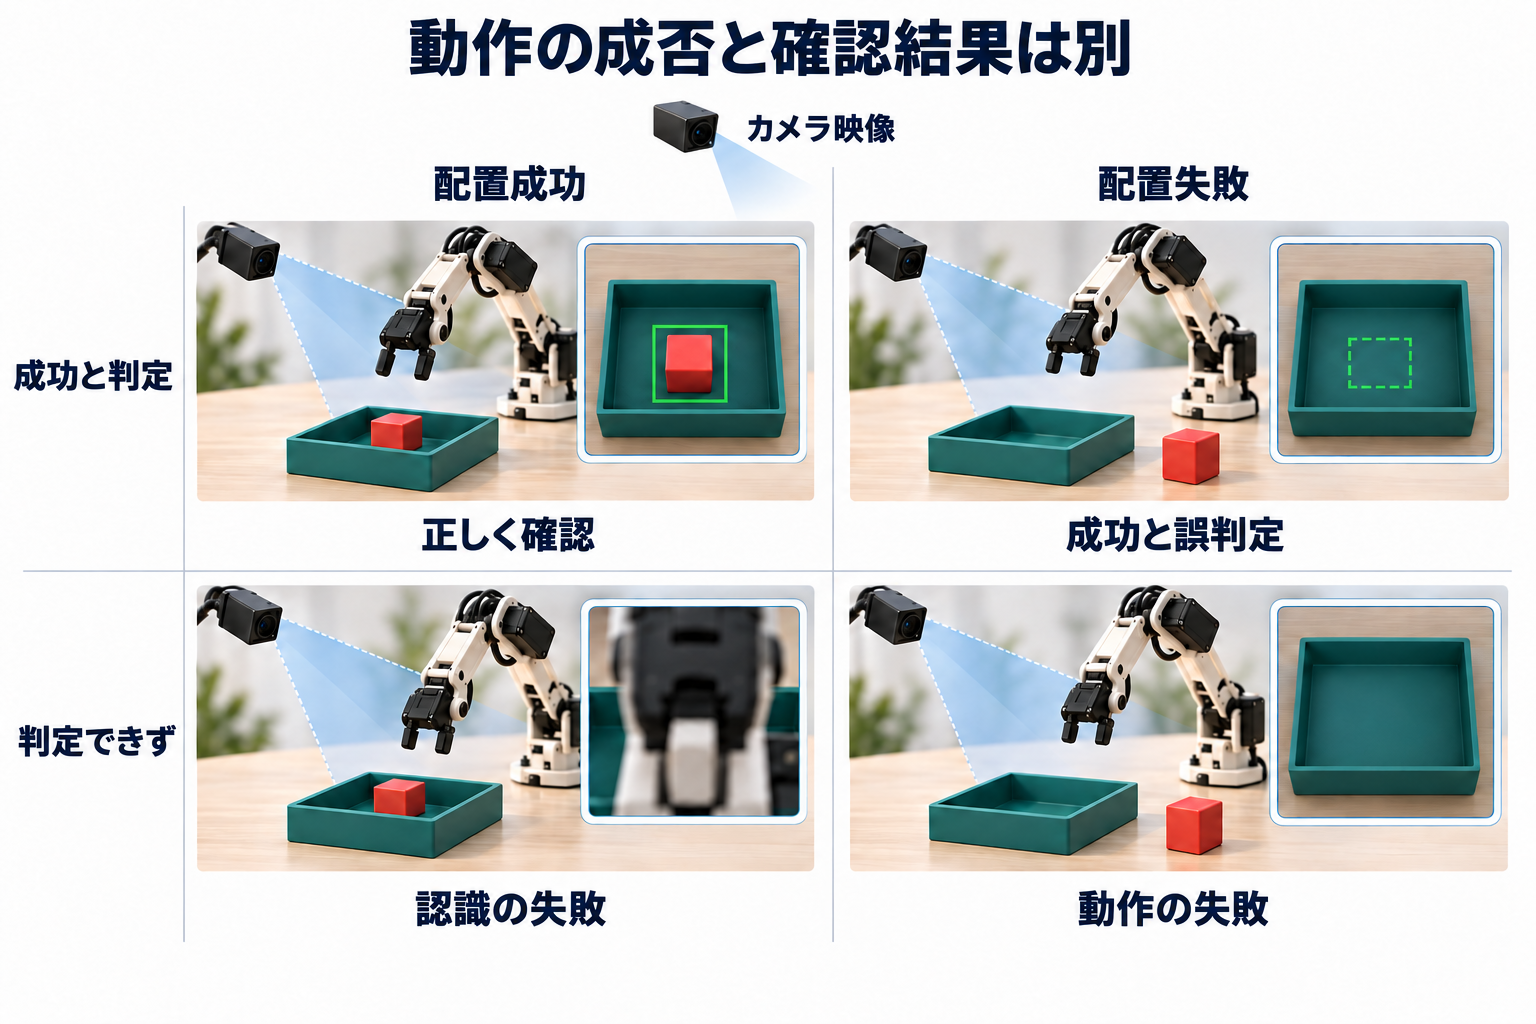
計画している比較では、作業の種類と評価専用の配置条件を固定し、認識・計画・動作スキルのうち一つだけを変更します。プログラム済みの基準システムは比較対象として残します。測定する項目は次のとおりです。
- 作業全体の成功率:先に置いた物体が正しい位置にとどまっているかも含めます。
- 再試行と人の支援:システム自身では解決できない失敗も含めます。
- 適応に必要な手間:条件の変化ごとに必要な追加の実演と調整を測ります。
改善を有用と判断するには、その効果、コスト、失敗する条件を明らかにする必要があります。
次に取り組むこと
次の目標は、範囲を限定した作業を実機のアームで実行して計測し、その後、条件を変えて試すことです。その結果を基に、より幅広い作業や将来のロボットに引き継ぐスキル、インターフェース、評価方法を選びます。
VoicePingにとって、この小さな研究プラットフォームは、ロボットの知能を信頼して任せられる仕事へとつなぐ力を育てるための出発点です。こうした課題に関心のある方は、VoicePingの採用情報 と研究記事 をご覧ください。